Express-Tutorial Teil 3: Eine Datenbank verwenden (mit Mongoose)
Dieser Artikel führt kurz in Datenbanken und ihre Verwendung mit Node-/Express-Anwendungen ein. Anschließend zeigt er, wie Mongoose den Datenbankzugriff für die Website LocalLibrary bereitstellt. Er erklärt, wie Objektschemas und Modelle definiert werden, stellt die wichtigsten Feldtypen und grundlegende Validierung vor und zeigt einige der wichtigsten Möglichkeiten für den Zugriff auf Modelldaten.
| Voraussetzungen: | Express-Tutorial Teil 2: Eine Website-Grundstruktur erstellen |
|---|---|
| Ziel: | Eigene Modelle mit Mongoose entwerfen und erstellen können. |
Überblick
Das Bibliothekspersonal wird die Local-Library-Website nutzen, um Informationen über Bücher und Ausleihende zu speichern. Bibliotheksmitglieder werden damit Bücher durchstöbern und suchen, prüfen, ob Exemplare verfügbar sind, und diese anschließend reservieren oder ausleihen. Um Informationen effizient zu speichern und abzurufen, legen wir sie in einer Datenbank ab.
Express-Anwendungen können viele verschiedene Datenbanken verwenden. Auch für Create (Erstellen), Read (Lesen), Update (Aktualisieren) und Delete (Löschen) – zusammen CRUD – gibt es mehrere Ansätze. Dieses Tutorial gibt einen kurzen Überblick über einige Möglichkeiten und erläutert anschließend die ausgewählten Verfahren im Detail.
Welche Datenbanken kann ich verwenden?
Express-Anwendungen können jede von Node unterstützte Datenbank verwenden. Express selbst legt keine zusätzlichen Verhaltensweisen oder Anforderungen für die Datenbankverwaltung fest. Es gibt viele gängige Optionen, darunter PostgreSQL, MySQL, Redis, SQLite und MongoDB.
Bei der Wahl einer Datenbank sollten Sie unter anderem berücksichtigen, wie schnell Sie produktiv arbeiten können, wie steil die Lernkurve ist, wie leistungsfähig die Datenbank ist, wie einfach sie sich replizieren und sichern lässt und welche Kosten sowie Community-Unterstützung zu erwarten sind. Die eine „beste“ Datenbank gibt es nicht. Für eine kleine bis mittelgroße Website wie unsere Local Library sollte jedoch nahezu jede der gängigen Lösungen gut geeignet sein.
Weitere Informationen zu den Optionen finden Sie unter Datenbankintegration (Express-Dokumentation).
Wie interagiere ich am besten mit einer Datenbank?
Für die Interaktion mit einer Datenbank gibt es zwei gängige Ansätze:
- Die native Abfragesprache der Datenbank verwenden, beispielsweise SQL.
- Einen Object Relational Mapper („ORM“) oder Object Document Mapper („ODM“) verwenden. Diese stellen die Daten der Website als JavaScript-Objekte dar und ordnen sie anschließend der zugrunde liegenden Datenbank zu. Manche ORMs und ODMs sind an eine bestimmte Datenbank gebunden, andere stellen ein datenbankunabhängiges Backend bereit.
Die höchste Leistung lässt sich mit SQL oder der jeweiligen Abfragesprache der Datenbank erzielen. Object Mapper sind häufig langsamer, weil sie mit Übersetzungscode zwischen Objekten und dem Datenbankformat vermitteln. Dabei verwenden sie möglicherweise nicht die effizientesten Datenbankabfragen. Das gilt besonders, wenn ein Mapper verschiedene Datenbank-Backends unterstützt und deshalb bei den unterstützten Datenbankfunktionen größere Kompromisse eingehen muss.
Ein ORM/ODM hat den Vorteil, dass Programmierende weiterhin in JavaScript-Objekten statt in Datenbankkonzepten denken können. Das ist besonders hilfreich, wenn Sie mit verschiedenen Datenbanken arbeiten müssen – auf derselben Website oder auf unterschiedlichen Websites. Außerdem bieten ORMs/ODMs einen naheliegenden Ort für die Datenvalidierung und können in der Regel TypeScript-Typen aus dem Datenschema ableiten.
Hinweis: Die Verwendung von ODMs/ORMs senkt häufig die Entwicklungs- und Wartungskosten! Sofern Sie mit der nativen Abfragesprache nicht sehr vertraut sind oder höchste Leistung nicht entscheidend ist, sollten Sie die Verwendung eines ODM ernsthaft in Betracht ziehen.
Welches ORM/ODM sollte ich verwenden?
Auf der Website des npm-Paketmanagers gibt es viele ODM-/ORM-Lösungen. Eine Auswahl finden Sie unter den Tags odm und orm.
Einige Lösungen, die zum Zeitpunkt der Erstellung dieses Artikels beliebt waren:
- Mongoose: Mongoose ist ein Werkzeug zur Objektmodellierung für MongoDB, das für den Einsatz in einer asynchronen Umgebung entwickelt wurde.
- Prisma ORM: Definiert Modelle in einer eigenen Schemadatei und erzeugt daraus einen Datenbank-Client. Dadurch erhalten Sie Autovervollständigung und Typprüfung für Abfragen Ihrer eigenen Modelle. Migrationswerkzeuge helfen dabei, die Datenbankstruktur mit dem Schema synchron zu halten.
- Drizzle ORM: Definiert Schemas direkt in TypeScript und bietet eine Abfrage-API, die sich eng an SQL orientiert. So können Entwicklerinnen und Entwickler mit SQL-Kenntnissen dieses Wissen für Joins und andere Abfragen nutzen und zugleich abgeleitete TypeScript-Typen erhalten, ohne einen separaten Datenbank-Client zu erzeugen.
- TypeORM: Ordnet Datenbankeinträge JavaScript- oder TypeScript-Klassen zu. Sie können Abfragemethoden direkt in den Modellklassen unterbringen (Active Record) oder den Datenbankzugriff in separate Repositories auslagern (Data Mapper). So können Sie selbst entscheiden, wie Sie Persistenz und Anwendungslogik organisieren.
- Sequelize: Ein Promise-basiertes ORM für Node.js und TypeScript. Es unterstützt die Dialekte PostgreSQL, MySQL, MariaDB, SQLite und MSSQL und bietet unter anderem zuverlässige Transaktionsunterstützung, Beziehungen und Lesereplikation.
- GraphQL: Eine Abfragesprache für APIs, die häufig als Alternative zu REST verwendet wird. Ein GraphQL-Server bezieht seine Daten über Resolver-Funktionen, die einen Datenbanktreiber oder ein ORM verwenden können.
Bei der Auswahl einer Lösung sollten Sie grundsätzlich sowohl die bereitgestellten Funktionen als auch die „Aktivität der Community“ berücksichtigen: Downloads, Beiträge, Fehlermeldungen, Qualität der Dokumentation und Ähnliches. Weitere Fragen sind:
- Erfordert das ORM eine separate Schemadatei, und sind zusätzliche Kompilierungsschritte erforderlich, um den verbindenden JavaScript-Code zu erhalten?
- Erzeugt es automatisch strenge TypeScript-Typen?
- Ist es für die Anwendung leistungsfähig genug?
- Kann es das Datenmodell der Anwendung ausreichend beschreiben?
Zum Zeitpunkt der Erstellung dieses Artikels ist Mongoose eine vernünftige Wahl, wenn Sie MongoDB als Datenbank verwenden.
Mongoose und MongoDB für die LocalLibrary verwenden
Für das Beispiel der Local Library und den Rest dieses Themas verwenden wir das Mongoose ODM, um auf unsere Bibliotheksdaten zuzugreifen. Mongoose dient als Schnittstelle zu MongoDB, einer quelloffenen NoSQL-Datenbank mit einem dokumentenorientierten Datenmodell. Eine „Collection“ von „Dokumenten“ in einer MongoDB-Datenbank entspricht ungefähr einer „Tabelle“ mit „Zeilen“ in einer relationalen Datenbank.
Diese Kombination aus ODM und Datenbank ist in der Node-Community äußerst beliebt. Ein Grund dafür ist, dass das System zum Speichern und Abfragen von Dokumenten JSON stark ähnelt und JavaScript-Entwicklerinnen und -Entwicklern daher vertraut ist.
Hinweis: Sie müssen MongoDB nicht kennen, um Mongoose verwenden zu können. Teile der Mongoose-Dokumentation lassen sich allerdings leichter verwenden und verstehen, wenn Sie bereits mit MongoDB vertraut sind.
Der Rest dieses Tutorials zeigt, wie Sie das Mongoose-Schema und die Modelle für die Beispielwebsite LocalLibrary definieren und darauf zugreifen.
Die LocalLibrary-Modelle entwerfen
Bevor Sie mit der Programmierung der Modelle beginnen, lohnt es sich, einige Minuten über die benötigten Daten und die Beziehungen zwischen den verschiedenen Objekten nachzudenken.
Wir wissen, dass wir Informationen über Bücher speichern müssen: Titel, Zusammenfassung, Autor, Genre und ISBN. Außerdem können mehrere Exemplare verfügbar sein, jeweils mit einer global eindeutigen ID, einem Verfügbarkeitsstatus und weiteren Angaben. Möglicherweise müssen wir über Autorinnen und Autoren mehr als nur ihren Namen speichern; außerdem können mehrere Personen gleiche oder ähnliche Namen haben. Die Informationen sollen sich nach Buchtitel, Autor, Genre und Kategorie sortieren lassen.
Beim Entwurf der Modelle ist es sinnvoll, für jedes „Objekt“ – also eine Gruppe zusammengehöriger Informationen – ein eigenes Modell anzulegen. Hier bieten sich Bücher, Buchexemplare und Autorinnen und Autoren an.
Sie können auch Modelle verwenden, um Optionen einer Auswahlliste darzustellen, beispielsweise Einträge in einer Dropdown-Liste, statt die Auswahlmöglichkeiten fest in der Website zu hinterlegen. Das empfiehlt sich, wenn nicht alle Optionen von Anfang an bekannt sind oder sich ändern können. Ein gutes Beispiel sind Genres wie Fantasy oder Science-Fiction.
Sobald Modelle und Felder feststehen, müssen wir über die Beziehungen zwischen ihnen nachdenken.
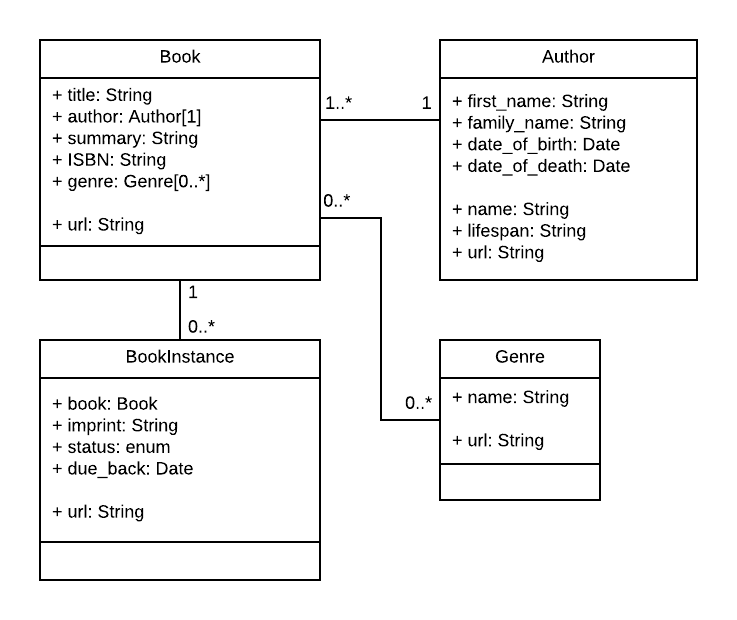
Das folgende UML-Assoziationsdiagramm zeigt die Modelle, die wir in diesem Fall definieren; sie sind als Kästen dargestellt. Wie oben erläutert, haben wir Modelle für das Buch (seine allgemeinen Angaben), das Buchexemplar (den Status eines bestimmten physischen Exemplars im System) und die Autorin oder den Autor vorgesehen. Auch für das Genre verwenden wir ein Modell, damit Werte dynamisch erstellt werden können. Für BookInstance:status haben wir uns gegen ein eigenes Modell entschieden: Die zulässigen Werte werden fest im Code hinterlegt, da wir nicht erwarten, dass sie sich ändern. In jedem Kasten sehen Sie den Modellnamen, die Namen und Typen der Felder sowie die Methoden und ihre Rückgabetypen.
Das Diagramm zeigt außerdem die Beziehungen zwischen den Modellen einschließlich ihrer Multiplizitäten. Die Zahlen im Diagramm geben an, wie viele Instanzen eines Modells mindestens und höchstens an einer Beziehung beteiligt sein können. Die Verbindungslinie zwischen den Kästen zeigt beispielsweise, dass Book und Genre miteinander verbunden sind. Die Zahlen nahe dem Modell Book bedeuten, dass zu einem Genre null oder mehr Book-Instanzen gehören können – beliebig viele. Die Zahlen am anderen Ende der Linie neben Genre bedeuten, dass einem Buch null oder mehr Genre-Instanzen zugeordnet sein können.
Hinweis:
Wie unten in unserer Einführung in Mongoose erläutert, ist es häufig besser, das Feld, das die Beziehung zwischen Dokumenten bzw. Modellen definiert, nur in einem Modell anzulegen. Die umgekehrte Beziehung lässt sich weiterhin ermitteln, indem Sie im anderen Modell nach der zugehörigen _id suchen. Hier haben wir die Beziehungen zwischen Book und Genre sowie zwischen Book und Author im Book-Schema definiert, die Beziehung zwischen Book und BookInstance dagegen im BookInstance-Schema. Diese Entscheidung war weitgehend beliebig – wir hätten das Feld genauso gut im jeweils anderen Schema anlegen können.
Hinweis: Der nächste Abschnitt führt in die Definition und Verwendung von Modellen ein. Überlegen Sie beim Lesen, wie wir die einzelnen Modelle aus dem obigen Diagramm erstellen werden.
Datenbank-APIs sind asynchron
Datenbankmethoden zum Erstellen, Suchen, Aktualisieren und Löschen von Datensätzen sind asynchron. Das bedeutet, dass die Methoden sofort zurückkehren. Der Code, der Erfolg oder Fehlschlag behandelt, wird erst später ausgeführt, wenn der Vorgang abgeschlossen ist. Während der Server auf den Abschluss eines Datenbankvorgangs wartet, kann anderer Code ausgeführt werden. So bleibt der Server für weitere Anfragen erreichbar.
JavaScript bietet verschiedene Mechanismen zur Unterstützung asynchronen Verhaltens. Früher wurden an asynchrone Methoden häufig Callback-Funktionen übergeben, um Erfolge und Fehler zu behandeln. In modernem JavaScript wurden Callbacks weitgehend durch Promises ersetzt. Promises sind Objekte, die eine asynchrone Methode sofort zurückgibt und die ihren zukünftigen Zustand repräsentieren. Wenn der Vorgang abgeschlossen ist, nimmt das Promise einen endgültigen Zustand an: Es wird mit einem Ergebnis erfüllt oder mit einem Fehler zurückgewiesen.
Es gibt zwei wesentliche Möglichkeiten, Code auszuführen, sobald ein Promise einen endgültigen Zustand erreicht hat. Wir empfehlen Ihnen ausdrücklich, für einen Überblick über beide Ansätze Promises verwenden zu lesen.
In diesem Tutorial verwenden wir hauptsächlich await, um innerhalb einer async function auf den Abschluss eines Promise zu warten. Dadurch wird asynchroner Code lesbarer und verständlicher.
Bei diesem Ansatz kennzeichnen Sie eine Funktion mit dem Schlüsselwort async function als asynchron und verwenden darin await für Methoden, die ein Promise zurückgeben.
Wenn die asynchrone Funktion ausgeführt wird, hält sie am ersten await an, bis das Promise einen endgültigen Zustand erreicht.
Aus Sicht des umgebenden Codes gibt die asynchrone Funktion dann zurück und der nachfolgende Code kann ausgeführt werden.
Sobald das Promise später einen endgültigen Zustand erreicht, liefert der Aufruf mit await innerhalb der asynchronen Funktion das Ergebnis zurück. Wurde das Promise zurückgewiesen, wird stattdessen ein Fehler ausgelöst.
Der Code in der asynchronen Funktion läuft anschließend weiter, bis er entweder auf ein weiteres await trifft und erneut anhält oder vollständig ausgeführt wurde.
Das folgende Beispiel zeigt die Funktionsweise.
myFunction() ist eine asynchrone Funktion mit einem try...catch-Block um die await-Ausdrücke.
Bei der Ausführung von myFunction() hält der Code bei methodThatReturnsPromise() an, bis das Promise erfüllt wird. Anschließend fährt er mit functionThatReturnsPromise() fort und wartet erneut.
Der Code im catch-Block wird ausgeführt, wenn in der asynchronen Funktion ein Fehler ausgelöst wird – etwa weil das Promise einer der beiden Methoden zurückgewiesen wurde.
async function myFunction() {
  try {
    // …
    await someObject.methodThatReturnsPromise();
    // …
    await functionThatReturnsPromise();
    // …
  } catch (e) {
    // error handling code
  }
}

myFunction();
Eine asynchrone Funktion gibt ein Promise zurück, das zurückgewiesen wird, wenn ein Fehler innerhalb der Funktion nicht abgefangen wird.
Um diesen Fehler im aufrufenden Code abzufangen, verwenden Sie die Methode catch() des zurückgegebenen Promise oder rufen die Funktion mit await innerhalb eines try...catch-Blocks auf.
Ein Funktionsaufruf innerhalb eines try...catch-Blocks ohne await fängt die Zurückweisung nicht ab: Erst await wandelt das zurückgegebene, zurückgewiesene Promise in einen ausgelösten Fehler um.
Die obigen asynchronen Methoden werden nacheinander ausgeführt.
Wenn die Methoden nicht voneinander abhängen, können Sie sie parallel ausführen und den gesamten Vorgang schneller abschließen.
Dazu dient die Methode Promise.all(). Sie nimmt ein Iterable von Promises entgegen und gibt ein einzelnes Promise zurück.
Dieses zurückgegebene Promise wird erfüllt, wenn alle übergebenen Promises erfüllt wurden; sein Ergebnis ist ein Array ihrer Ergebnisse.
Wird eines der übergebenen Promises zurückgewiesen, wird auch das zurückgegebene Promise mit dem Grund der ersten Zurückweisung zurückgewiesen.
Der folgende Code zeigt, wie das funktioniert.
Zunächst haben wir zwei Funktionen, die Promises zurückgeben.
Mit await warten wir über das von Promise.all() zurückgegebene Promise darauf, dass beide abgeschlossen werden.
Sind beide abgeschlossen, liefert await ein Ergebnis und das Ergebnisarray wird gefüllt. Danach fährt die Funktion mit dem nächsten await fort und wartet, bis das von anotherFunctionThatReturnsPromise() zurückgegebene Promise einen endgültigen Zustand erreicht.
Um Fehler abzufangen, würden Sie dem von myFunction() zurückgegebenen Promise einen catch()-Handler hinzufügen.
async function myFunction() {
  // …
  const [resultFunction1, resultFunction2] = await Promise.all([
    functionThatReturnsPromise1(),
    functionThatReturnsPromise2(),
  ]);
  // …
  await anotherFunctionThatReturnsPromise(resultFunction1);
}
Promises mit await/async ermöglichen eine flexible und zugleich gut verständliche Steuerung asynchroner Abläufe!
Einführung in Mongoose
Dieser Abschnitt gibt einen Überblick darüber, wie Sie Mongoose mit einer MongoDB-Datenbank verbinden, Schemas und Modelle definieren und einfache Abfragen ausführen.
Hinweis: Diese Einführung orientiert sich stark am Mongoose-Schnellstart auf npm und an der offiziellen Dokumentation.
Mongoose und MongoDB installieren
Mongoose wird wie jede andere Abhängigkeit mit npm in Ihrem Projekt (package.json) installiert. Führen Sie dazu im Projektordner folgenden Befehl aus:
npm install mongoose
Bei der Installation von Mongoose werden alle zugehörigen Abhängigkeiten hinzugefügt, einschließlich des MongoDB-Datenbanktreibers. MongoDB selbst wird jedoch nicht installiert. Wenn Sie einen MongoDB-Server installieren möchten, können Sie hier Installationsprogramme für verschiedene Betriebssysteme herunterladen und ihn lokal installieren. Sie können auch cloudbasierte MongoDB-Instanzen verwenden.
Hinweis: Für dieses Tutorial verwenden wir das kostenlose Angebot des cloudbasierten Database-as-a-Service-Dienstes MongoDB Atlas als Datenbank. Es eignet sich für die Entwicklung und ist für dieses Tutorial sinnvoll, weil die „Installation“ damit unabhängig vom Betriebssystem ist. Database as a Service ist auch ein möglicher Ansatz für Ihre Produktionsdatenbank.
Verbindung zu MongoDB herstellen
Mongoose benötigt eine Verbindung zu einer MongoDB-Datenbank.
Sie können Mongoose importieren und mit mongoose.connect() wie unten gezeigt eine Verbindung zu einer lokal betriebenen Datenbank herstellen. Im Tutorial verbinden wir uns stattdessen mit einer im Internet gehosteten Datenbank.
import mongoose from "mongoose";

// Define the database URL to connect to.
const mongoDB = "mongodb://127.0.0.1/my_database";

// Wait for database to connect, logging an error if there is a problem
main().catch((err) => console.log(err));
async function main() {
  await mongoose.connect(mongoDB);
}
Hinweis:
Wie im Abschnitt Datenbank-APIs sind asynchron erläutert, warten wir hier innerhalb einer async-Funktion mit await auf das von der Methode connect() zurückgegebene Promise.
Fehler beim Verbindungsaufbau behandeln wir mit dem Promise-Handler catch(). Alternativ könnten wir await main() innerhalb eines try...catch-Blocks in einer anderen async-Funktion verwenden.
Das standardmäßige Connection-Objekt erhalten Sie über mongoose.connection.
Wenn Sie weitere Verbindungen benötigen, können Sie mongoose.createConnection() verwenden.
Diese Methode nimmt dieselbe Form einer Datenbank-URI mit Host, Datenbank, Port, Optionen usw. entgegen wie connect() und gibt ein Connection-Objekt zurück.
Beachten Sie, dass createConnection() sofort zurückkehrt. Wenn Sie warten müssen, bis die Verbindung hergestellt ist, können Sie asPromise() aufrufen, um ein Promise zu erhalten (mongoose.createConnection(mongoDB).asPromise()).
Modelle definieren und erstellen
Modelle werden über die Schema-Schnittstelle definiert. Mit einem Schema legen Sie die Felder fest, die in jedem Dokument gespeichert werden, sowie deren Validierungsanforderungen und Standardwerte. Außerdem können Sie statische und instanzbezogene Hilfsmethoden definieren, um die Arbeit mit Ihren Datentypen zu erleichtern. Auch virtuelle Eigenschaften sind möglich: Sie lassen sich wie andere Felder verwenden, werden aber nicht in der Datenbank gespeichert. Darauf gehen wir weiter unten näher ein.
Anschließend werden Schemas mit der Methode mongoose.model() zu Modellen „kompiliert“. Mit einem Modell können Sie Objekte des jeweiligen Typs suchen, erstellen, aktualisieren und löschen.
Hinweis:
Jedes Modell entspricht einer Collection von Dokumenten in der MongoDB-Datenbank. Die Dokumente enthalten die Felder und Schematypen, die im Schema des Modells definiert sind.
Schemas definieren
Der folgende Codeausschnitt zeigt, wie Sie ein einfaches Schema definieren können. Zuerst importieren Sie mongoose. Anschließend erzeugen Sie mit dem Schema-Konstruktor eine neue Schemainstanz und definieren die verschiedenen Felder im Objektparameter des Konstruktors.
import mongoose from "mongoose";

// Define a schema
const Schema = mongoose.Schema;

const SomeModelSchema = new Schema({
  a_string: String,
  a_date: Date,
});
Im obigen Beispiel haben wir nur zwei Felder: eine Zeichenfolge und ein Datum. In den nächsten Abschnitten stellen wir einige weitere Feldtypen, Validierungsmöglichkeiten und Methoden vor.
Ein Modell erstellen
Modelle werden mit der Methode mongoose.model() aus Schemas erstellt:
// Define schema
const Schema = mongoose.Schema;

const SomeModelSchema = new Schema({
  a_string: String,
  a_date: Date,
});

// Compile model from schema
const SomeModel = mongoose.model("SomeModel", SomeModelSchema);
Das erste Argument ist der Name im Singular für die Collection, die für Ihr Modell erstellt wird – Mongoose erstellt im obigen Beispiel die Datenbank-Collection für das Modell SomeModel. Das zweite Argument ist das Schema, das Sie für das Modell verwenden möchten.
Hinweis: Sobald Ihre Modellklassen definiert sind, können Sie damit Datensätze erstellen, aktualisieren und löschen sowie Abfragen nach allen Datensätzen oder bestimmten Teilmengen ausführen. Wie das geht, zeigen wir im Abschnitt Modelle verwenden und beim Erstellen unserer Ansichten.
Schematypen (Felder)
Ein Schema kann beliebig viele Felder haben. Jedes davon steht für ein Feld in den in MongoDB gespeicherten Dokumenten. Das folgende Beispielschema zeigt viele gängige Feldtypen und wie sie deklariert werden.
const schema = new Schema({
  name: String,
  binary: Buffer,
  living: Boolean,
  updated: { type: Date, default: Date.now() },
  age: { type: Number, min: 18, max: 65, required: true },
  mixed: Schema.Types.Mixed,
  _someId: Schema.Types.ObjectId,
  array: [],
  ofString: [String], // You can also have an array of each of the other types too.
  nested: { stuff: { type: String, lowercase: true, trim: true } },
});
Die meisten SchemaTypes – die Bezeichnungen nach „type:“ oder nach Feldnamen – erklären sich von selbst. Ausnahmen sind:
ObjectId: Repräsentiert bestimmte Instanzen eines Modells in der Datenbank. Ein Buch könnte damit beispielsweise sein Autor-Objekt referenzieren. Das Feld enthält tatsächlich die eindeutige ID (_id) des angegebenen Objekts. Mit der Methodepopulate()können wir die zugehörigen Informationen bei Bedarf laden.Mixed: Ein beliebiger Schematyp.[]: Ein Array von Elementen. Auf diesen Modellen können Sie JavaScript-Array-Operationen wie push, pop oder unshift ausführen. Die obigen Beispiele zeigen ein Array von Objekten ohne festgelegten Typ und ein Array vonString-Objekten. Arrays können jedoch Objekte beliebiger Typen enthalten.
Der Code zeigt außerdem beide Möglichkeiten, ein Feld zu deklarieren:
- Feld-name und -typ als Schlüssel-Wert-Paar, wie bei den Feldern
name,binaryundliving. - Feld-name, gefolgt von einem Objekt, das
typeund weitere Optionen für das Feld definiert. Zu den Optionen gehören:- Standardwerte.
- Integrierte Validatoren, etwa für Höchst- und Mindestwerte, sowie eigene Validierungsfunktionen.
- Ob das Feld erforderlich ist.
- Ob
String-Felder automatisch in Klein- oder Großbuchstaben umgewandelt oder von Leerzeichen am Anfang und Ende bereinigt werden sollen, beispielsweise{ type: String, lowercase: true, trim: true }.
Weitere Informationen zu den Optionen finden Sie unter SchemaTypes (Mongoose-Dokumentation).
Validierung
Mongoose bietet integrierte und eigene sowie synchrone und asynchrone Validatoren. Sie können damit jeweils sowohl den zulässigen Wertebereich als auch die Fehlermeldung für einen Validierungsfehler festlegen.
Zu den integrierten Validatoren gehören:
- Alle SchemaTypes verfügen über den integrierten Validator required. Damit legen Sie fest, ob ein Feld angegeben werden muss, damit ein Dokument gespeichert werden kann.
- Zahlen verfügen über die Validatoren min und max.
- Zeichenfolgen verfügen über:
Das folgende, leicht an die Mongoose-Dokumentation angelehnte Beispiel zeigt, wie Sie einige Validatortypen und Fehlermeldungen festlegen können:
const breakfastSchema = new Schema({
  eggs: {
    type: Number,
    min: [6, "Too few eggs"],
    max: 12,
    required: [true, "Why no eggs?"],
  },
  drink: {
    type: String,
    enum: ["Coffee", "Tea", "Water"],
  },
});
Vollständige Informationen zur Feldvalidierung finden Sie unter Validierung (Mongoose-Dokumentation).
Virtuelle Eigenschaften
Virtuelle Eigenschaften sind Dokumenteigenschaften, die Sie lesen und setzen können, die aber nicht in MongoDB gespeichert werden. Getter eignen sich zum Formatieren oder Kombinieren von Feldern. Setter sind nützlich, um einen einzelnen Wert zur Speicherung in mehrere Werte aufzuteilen. Das Beispiel in der Dokumentation erstellt eine virtuelle Eigenschaft für den vollständigen Namen aus den Feldern für Vor- und Nachnamen und zerlegt ihn wieder. Das ist einfacher und übersichtlicher, als den vollständigen Namen jedes Mal neu zusammenzusetzen, wenn er in einer Vorlage benötigt wird.
Hinweis:
In der Bibliothek verwenden wir eine virtuelle Eigenschaft, um für jeden Modelldatensatz anhand eines Pfads und seines _id-Werts eine eindeutige URL zu definieren.
Weitere Informationen finden Sie unter Virtuelle Eigenschaften (Mongoose-Dokumentation).
Methoden und Abfragehilfen
Ein Schema kann auch Instanzmethoden, statische Methoden und Abfragehilfen enthalten. Instanzmethoden und statische Methoden ähneln sich. Der wesentliche Unterschied besteht darin, dass eine Instanzmethode einem bestimmten Datensatz zugeordnet ist und auf das aktuelle Objekt zugreifen kann. Mit Abfragehilfen können Sie die verkettbare Query-Builder-API von mongoose erweitern und beispielsweise zusätzlich zu find(), findOne() und findById() eine Abfrage „byName“ hinzufügen.
Modelle verwenden
Nachdem Sie ein Schema erstellt haben, können Sie daraus Modelle erzeugen. Ein Modell repräsentiert eine durchsuchbare Collection von Dokumenten in der Datenbank. Die Instanzen des Modells repräsentieren einzelne Dokumente, die Sie speichern und abrufen können.
Im Folgenden geben wir einen kurzen Überblick. Weitere Informationen finden Sie unter Modelle (Mongoose-Dokumentation).
Hinweis:
Das Erstellen, Aktualisieren, Löschen und Abfragen von Datensätzen sind asynchrone Vorgänge, die ein Promise zurückgeben.
Die folgenden Beispiele zeigen nur die Verwendung der jeweiligen Methoden und von await, also den wesentlichen Code für die Methoden.
Die umgebende async function und der try...catch-Block zum Abfangen von Fehlern wurden der Übersichtlichkeit halber weggelassen.
Weitere Informationen zur Verwendung von await/async finden Sie oben unter Datenbank-APIs sind asynchron.
Dokumente erstellen und ändern
Um einen Datensatz zu erstellen, können Sie eine Instanz des Modells definieren und darauf save() aufrufen.
Die folgenden Beispiele setzen voraus, dass SomeModel ein aus unserem Schema erstelltes Modell mit einem einzigen Feld name ist.
// Create an instance of model SomeModel
const awesome_instance = new SomeModel({ name: "awesome" });

// Save the new model instance asynchronously
await awesome_instance.save();
Mit create() können Sie eine Modellinstanz auch gleichzeitig definieren und speichern.
Im folgenden Beispiel erstellen wir nur eine Instanz. Sie können aber auch mehrere Instanzen erstellen, indem Sie ein Array von Objekten übergeben.
await SomeModel.create({ name: "also_awesome" });
Jedem Modell ist eine Verbindung zugeordnet. Wenn Sie mongoose.model() verwenden, ist das die Standardverbindung. Um Dokumente in einer anderen Datenbank zu erstellen, können Sie eine neue Verbindung herstellen und darauf .model() aufrufen.
Auf die Felder des neuen Datensatzes können Sie mit der Punktschreibweise zugreifen und ihre Werte ändern. Um geänderte Werte wieder in der Datenbank zu speichern, müssen Sie save() oder update() aufrufen.
// Access model field values using dot notation
console.log(awesome_instance.name); // should log 'also_awesome'

// Change record by modifying the fields, then calling save().
awesome_instance.name = "New cool name";
await awesome_instance.save();
Nach Datensätzen suchen
Mit Abfragemethoden können Sie nach Datensätzen suchen und die Abfragebedingungen als JSON-Dokument angeben. Der folgende Codeausschnitt zeigt, wie Sie in einer Datenbank alle Athletinnen und Athleten finden könnten, die Tennis spielen, und dabei nur die Felder für Name und Alter zurückgeben. Hier geben wir nur ein Feld als Suchbedingung an (Sport). Sie können weitere Kriterien oder reguläre Ausdrücke hinzufügen oder die Bedingungen ganz weglassen, um alle Athletinnen und Athleten zurückzugeben.
const Athlete = mongoose.model("Athlete", yourSchema);

// find all athletes who play tennis, returning the 'name' and 'age' fields
const tennisPlayers = await Athlete.find(
  { sport: "Tennis" },
  "name age",
).exec();
Hinweis: Beachten Sie: Wenn eine Suche keine Ergebnisse liefert, ist das kein Fehler. Im Kontext Ihrer Anwendung kann es dennoch ein unerwünschtes Ergebnis sein. Falls Ihre Anwendung erwartet, dass eine Suche einen Wert findet, können Sie die Anzahl der zurückgegebenen Einträge prüfen.
Abfrage-APIs wie find() geben einen Wert vom Typ Query zurück.
Mit einem Abfrageobjekt können Sie eine Abfrage schrittweise aufbauen, bevor Sie sie mit der Methode exec() ausführen.
exec() führt die Abfrage aus und gibt ein Promise zurück, auf dessen Ergebnis Sie mit await warten können.
// find all athletes that play tennis
const query = Athlete.find({ sport: "Tennis" });

// selecting the 'name' and 'age' fields
query.select("name age");

// limit our results to 5 items
query.limit(5);

// sort by age
query.sort({ age: -1 });

// execute the query at a later time
query.exec();
Oben haben wir die Abfragebedingungen in der Methode find() definiert. Dafür können wir auch eine where()-Funktion verwenden. Außerdem lassen sich alle Teile der Abfrage mit dem Punktoperator (.) verketten, statt sie einzeln hinzuzufügen.
Der folgende Codeausschnitt entspricht unserer obigen Abfrage, enthält aber eine zusätzliche Bedingung für das Alter.
Athlete.find()
  .where("sport")
  .equals("Tennis")
  .where("age")
  .gt(17)
  .lt(50) // Additional where query
  .limit(5)
  .sort({ age: -1 })
  .select("name age")
  .exec();
Die Methode find() liefert alle passenden Datensätze. Oft benötigen Sie jedoch nur einen Treffer. Die folgenden Methoden fragen einen einzelnen Datensatz ab:
findById(): Findet das Dokument mit der angegebenenid(jedes Dokument hat eine eindeutigeid).findOne(): Findet ein einzelnes Dokument, das den angegebenen Kriterien entspricht.findByIdAndDelete(),findByIdAndUpdate(),findOneAndRemove(),findOneAndUpdate(): Finden ein einzelnes Dokument anhand seineridoder bestimmter Kriterien und aktualisieren oder entfernen es. Diese Hilfsfunktionen erleichtern das Aktualisieren und Entfernen von Datensätzen.
Hinweis:
Mit der Methode countDocuments() können Sie außerdem ermitteln, wie viele Einträge bestimmten Bedingungen entsprechen. Das ist nützlich, wenn Sie Datensätze zählen möchten, ohne sie tatsächlich abzurufen.
Mit Abfragen ist noch deutlich mehr möglich. Weitere Informationen finden Sie unter Abfragen (Mongoose-Dokumentation).
Mit verknüpften Dokumenten arbeiten – Population
Mit dem Schemafeld ObjectId können Sie eine Referenz von einer Dokument- bzw. Modellinstanz auf eine andere erstellen. Für Referenzen von einem Dokument auf mehrere verwenden Sie ein Array von ObjectIds. Das Feld speichert die ID des verknüpften Modells. Wenn Sie den tatsächlichen Inhalt des zugehörigen Dokuments benötigen, können Sie in einer Abfrage die Methode populate() verwenden, um die ID durch die eigentlichen Daten zu ersetzen.
Das folgende Schema definiert beispielsweise Autorinnen und Autoren sowie Geschichten.
Jede Autorin und jeder Autor kann mehrere Geschichten haben, die wir als Array von ObjectId-Werten darstellen.
Jede Geschichte kann genau eine Autorin oder einen Autor haben.
Die Eigenschaft ref teilt dem Schema mit, welches Modell diesem Feld zugewiesen werden kann.
import mongoose from "mongoose";

const Schema = mongoose.Schema;

const authorSchema = new Schema({
  name: String,
  stories: [{ type: Schema.Types.ObjectId, ref: "Story" }],
});

const storySchema = new Schema({
  author: { type: Schema.Types.ObjectId, ref: "Author" },
  title: String,
});

const Story = mongoose.model("Story", storySchema);
const Author = mongoose.model("Author", authorSchema);
Wir können eine Referenz auf das verknüpfte Dokument speichern, indem wir den Wert _id zuweisen.
Im Folgenden erstellen wir erst eine Autorin oder einen Autor, dann eine Geschichte und weisen die Autoren-ID dem Autorenfeld der Geschichte zu.
const bob = new Author({ name: "Bob Smith" });

await bob.save();

// Bob now exists, so let's create a story
const story = new Story({
  title: "Bob goes sledding",
  author: bob._id, // assign the _id from our author Bob. This ID is created by default!
});

await story.save();
Hinweis:
Ein großer Vorteil dieses Programmierstils ist, dass wir den Hauptablauf unseres Codes nicht durch Fehlerprüfungen verkomplizieren müssen.
Schlägt eine der save()-Operationen fehl, wird das Promise zurückgewiesen und ein Fehler ausgelöst.
Unser Code zur Fehlerbehandlung kümmert sich separat darum, normalerweise in einem catch()-Block. Dadurch bleibt die Absicht unseres Codes klar erkennbar.
Unser Geschichtendokument referenziert nun eine Autorin oder einen Autor über die ID des Autorendokuments. Um die Autoreninformationen zusammen mit den Ergebnissen für Geschichten zu erhalten, verwenden wir populate(), wie unten gezeigt.
Story.findOne({ title: "Bob goes sledding" })
  .populate("author") // Replace the author id with actual author information in results
  .exec();
Hinweis:
Aufmerksamen Leserinnen und Lesern ist vielleicht aufgefallen, dass wir unserer Geschichte eine Autorin oder einen Autor zugewiesen haben, die Geschichte aber nicht zum Array stories des Autorendokuments hinzugefügt haben. Wie können wir dann alle Geschichten einer bestimmten Person abrufen? Eine Möglichkeit wäre, die Geschichte dem Array hinzuzufügen. Dann müssten wir die Informationen über die Beziehung zwischen Autorinnen und Autoren und Geschichten allerdings an zwei Stellen pflegen.
Besser ist es, die _id unseres Autorendokuments abzurufen und anschließend mit find() im Autorenfeld aller Geschichten danach zu suchen.
Story.find({ author: bob._id }).exec();
Das ist nahezu alles, was Sie für dieses Tutorial über die Arbeit mit verknüpften Einträgen wissen müssen. Ausführlichere Informationen finden Sie unter Population (Mongoose-Dokumentation).
Ein Schema/Modell pro Datei
Sie können Schemas und Modelle in einer beliebigen Dateistruktur anlegen. Wir empfehlen jedoch ausdrücklich, jedes Modellschema in einem eigenen Modul (einer eigenen Datei) zu definieren und das Modell anschließend zu exportieren. Das sieht folgendermaßen aus:
// File: ./models/some-model.js

// Import Mongoose
import mongoose from "mongoose";

// Define a schema
const Schema = mongoose.Schema;

const SomeModelSchema = new Schema({
  a_string: String,
  a_date: Date,
});

// Export model
export default mongoose.model("SomeModel", SomeModelSchema);
Danach können Sie das Modell in anderen Dateien direkt importieren und verwenden. Unten zeigen wir, wie Sie damit beispielsweise alle Instanzen des Modells abrufen können.
// Import the SomeModel model
import SomeModel from "../models/some-model.js";

// Use the SomeModel object (model) to find all SomeModel records
const modelInstances = await SomeModel.find().exec();
Die MongoDB-Datenbank einrichten
Da wir nun wissen, was Mongoose leisten kann und wie wir unsere Modelle gestalten möchten, können wir mit der Arbeit an der LocalLibrary-Website beginnen. Als Erstes richten wir eine MongoDB-Datenbank ein, in der wir unsere Bibliotheksdaten speichern können.
Für dieses Tutorial verwenden wir die cloudgehostete Sandbox-Datenbank von MongoDB Atlas. Diese Datenbankstufe gilt nicht als geeignet für produktive Websites, weil sie keine Redundanz bietet. Für die Entwicklung und das Erstellen von Prototypen ist sie jedoch hervorragend geeignet. Wir verwenden sie hier, weil sie kostenlos und einfach einzurichten ist. Außerdem ist MongoDB Atlas ein beliebter Database-as-a-Service-Anbieter, den Sie auch für Ihre Produktionsdatenbank wählen könnten. Weitere zum Zeitpunkt der Erstellung dieses Artikels beliebte Optionen sind Supabase, Firebase Firestore und Cloudflare D1.
Hinweis: Wenn Sie möchten, können Sie eine MongoDB-Datenbank lokal einrichten, indem Sie die passenden Binärdateien für Ihr System herunterladen und installieren. Die weiteren Anweisungen in diesem Artikel wären ähnlich; lediglich die beim Verbindungsaufbau angegebene Datenbank-URL wäre anders. Im Tutorial Express-Tutorial Teil 7: Bereitstellung für die Produktion hosten wir sowohl die Anwendung als auch die Datenbank auf Railway. Wir könnten genauso gut eine Datenbank auf MongoDB Atlas verwenden.
Zunächst müssen Sie bei MongoDB Atlas ein Konto erstellen. Das ist kostenlos; Sie müssen lediglich grundlegende Kontaktdaten angeben und die Nutzungsbedingungen bestätigen.
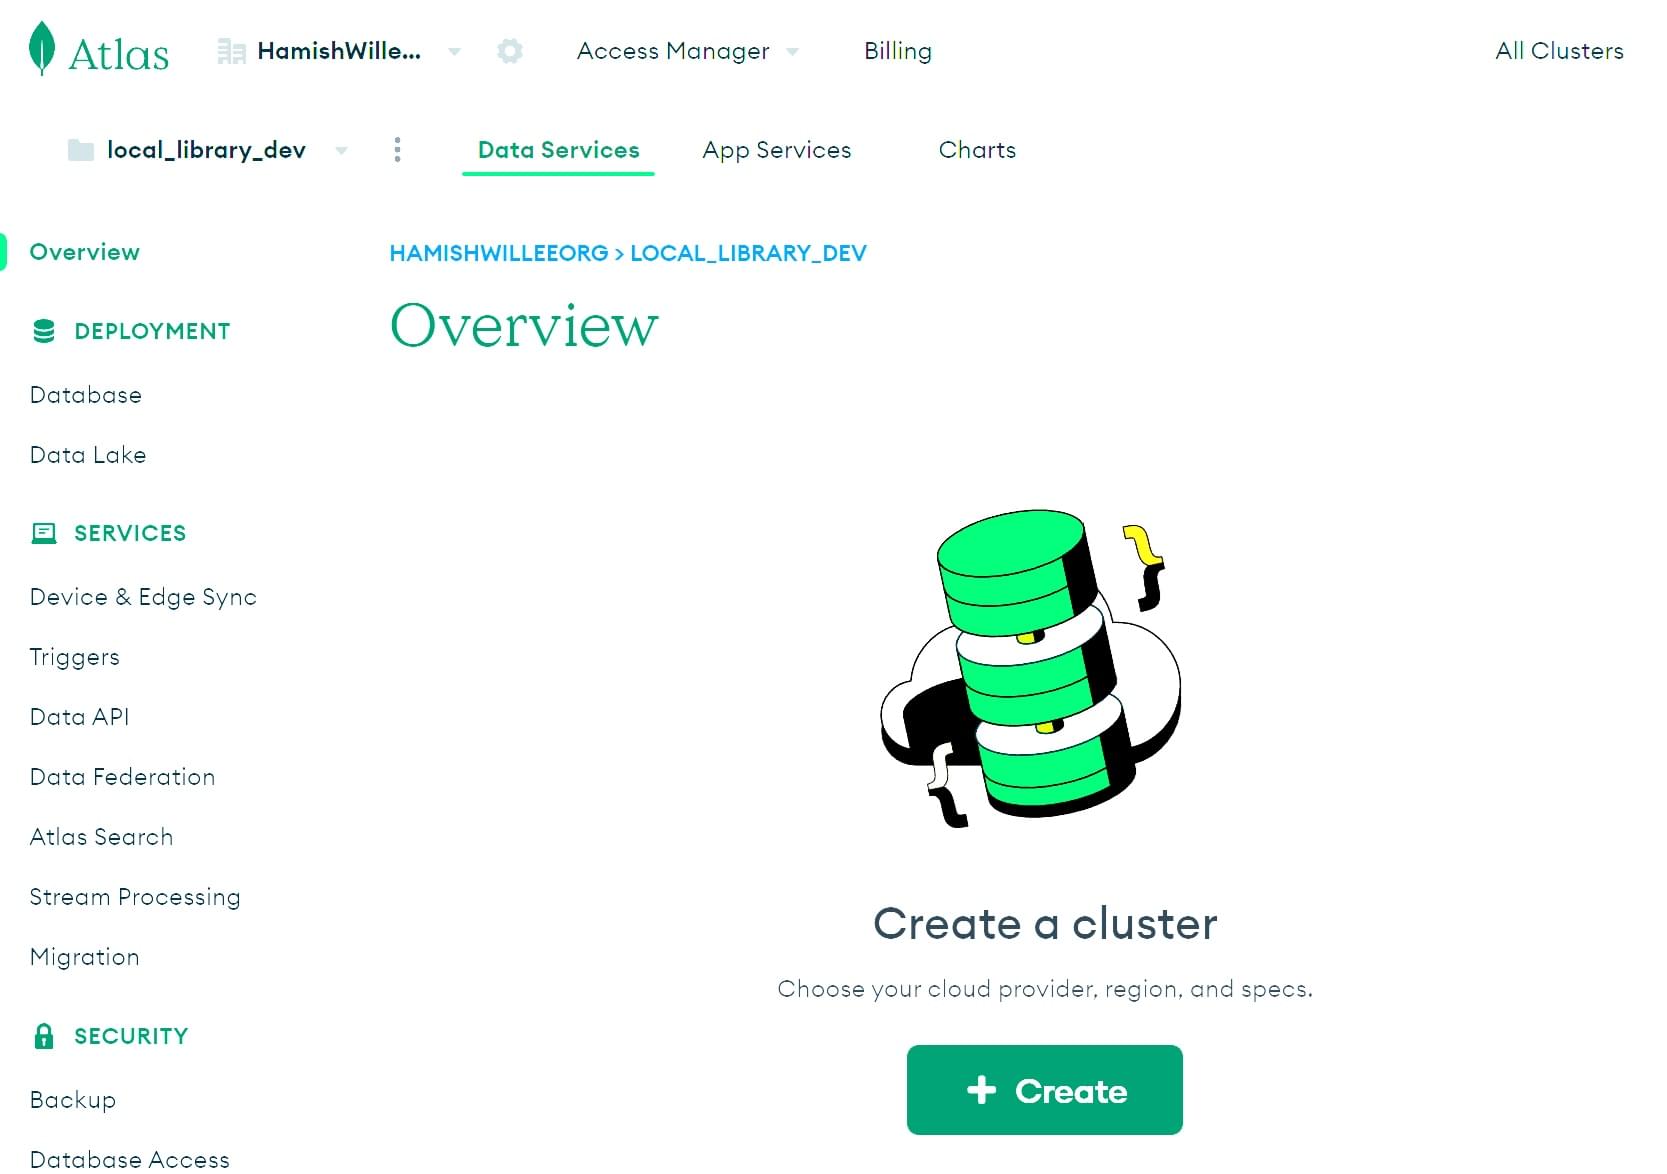
Nach der Anmeldung gelangen Sie zur Startseite:
-
Klicken Sie im Bereich Overview auf + Create.
-
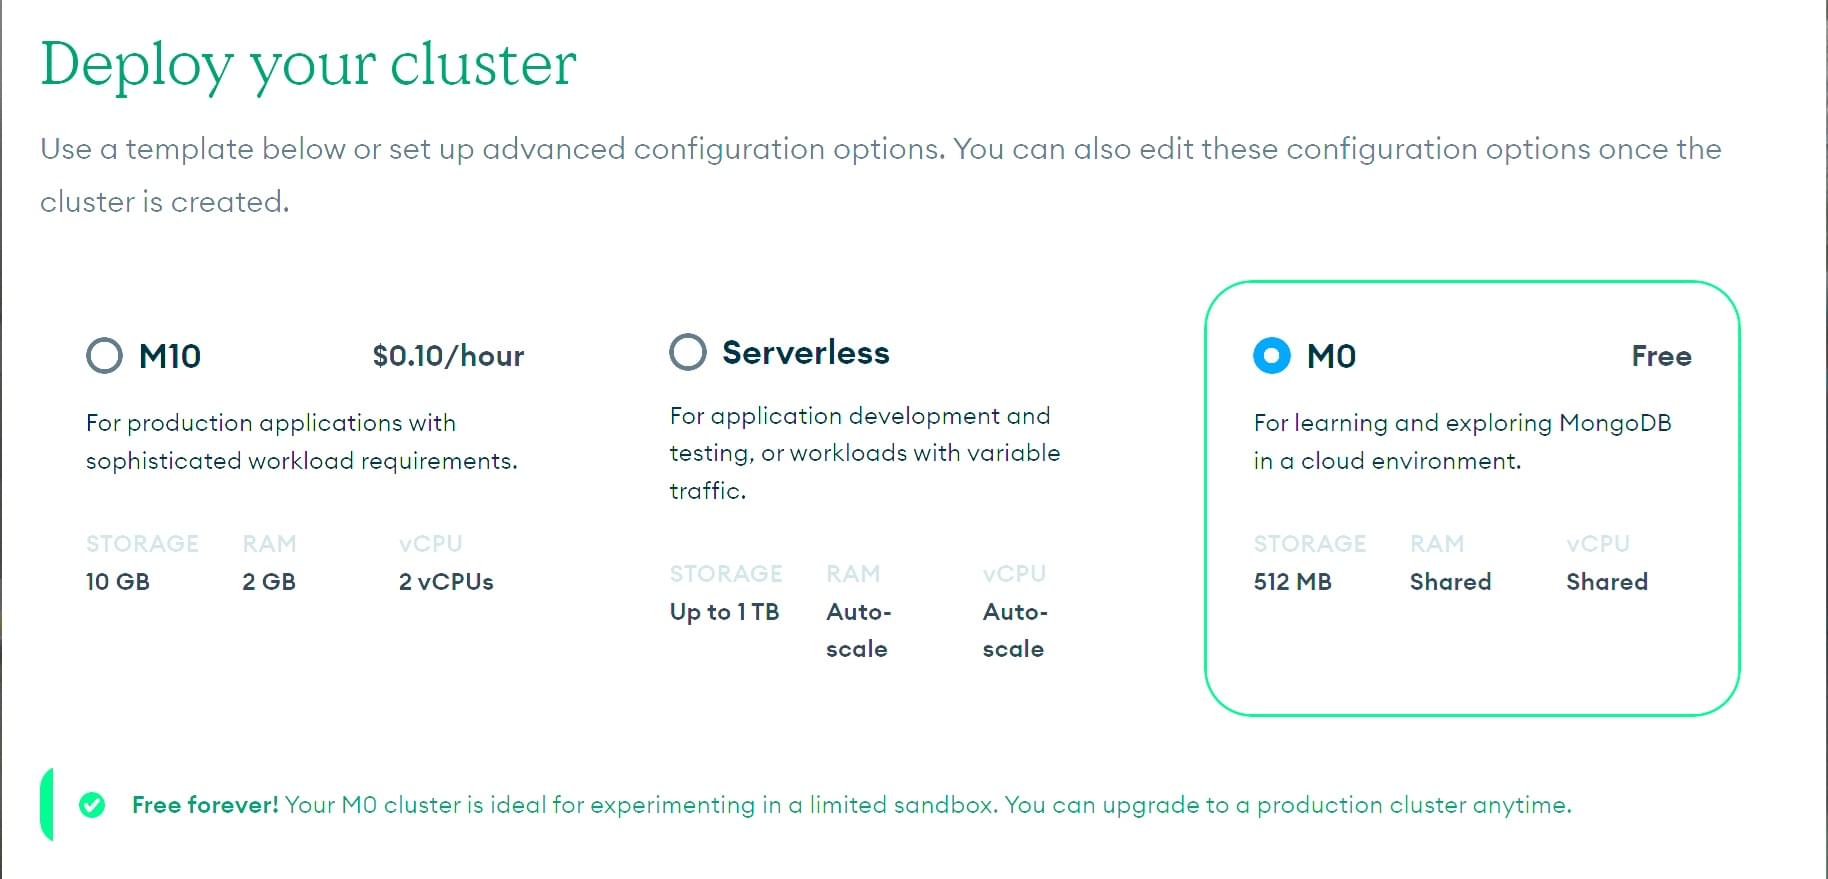
Daraufhin öffnet sich die Ansicht Deploy your cluster. Klicken Sie auf die Option M0 FREE.
-
Scrollen Sie auf der Seite nach unten, um die verschiedenen verfügbaren Optionen zu sehen.
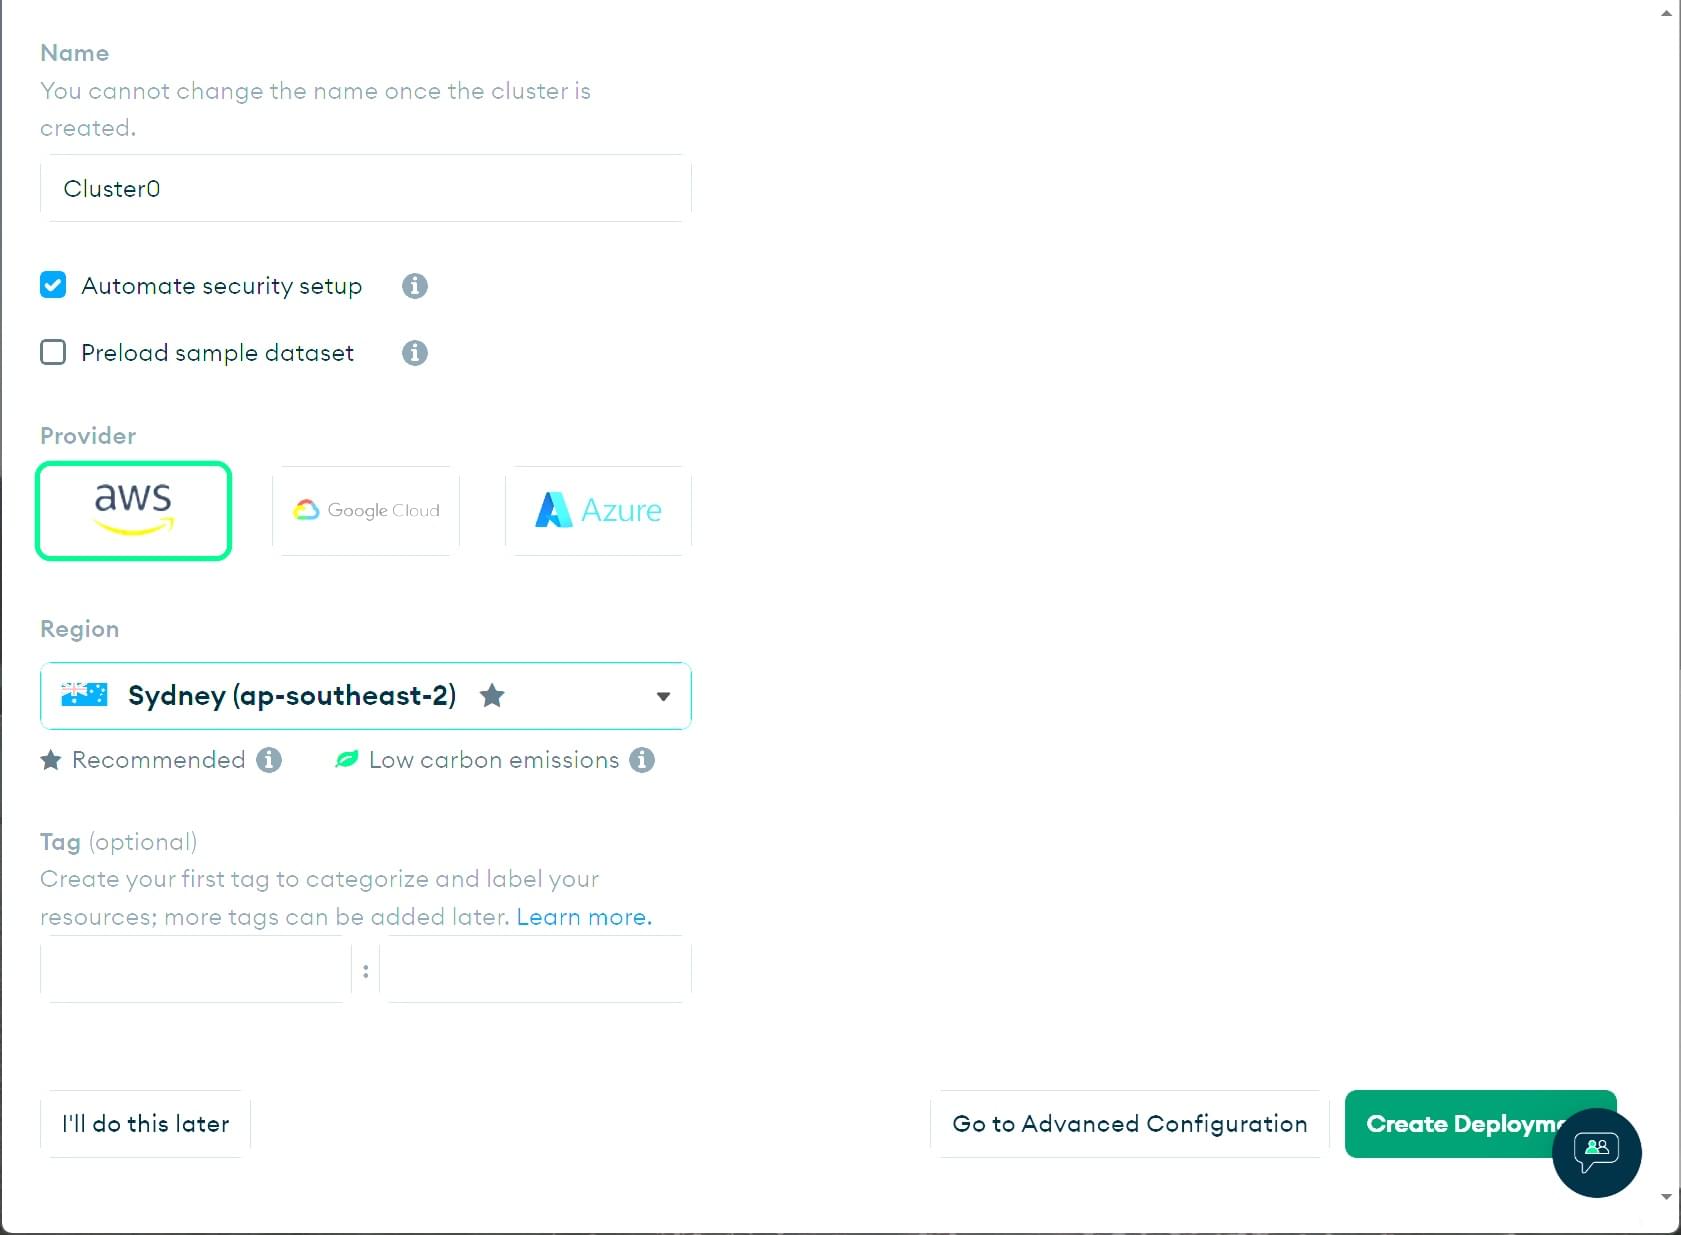
- Unter Cluster Name können Sie den Namen Ihres Clusters ändern.
Für dieses Tutorial belassen wir ihn bei
Cluster0. - Deaktivieren Sie das Kontrollkästchen Preload sample dataset, da wir später eigene Beispieldaten importieren.
- Wählen Sie unter Provider und Region einen beliebigen Anbieter und eine Region aus. In verschiedenen Regionen stehen unterschiedliche Anbieter zur Verfügung.
- Tags sind optional. Wir verwenden hier keine.
- Klicken Sie auf Create deployment. Das Erstellen des Clusters dauert einige Minuten.
- Unter Cluster Name können Sie den Namen Ihres Clusters ändern.
Für dieses Tutorial belassen wir ihn bei
-
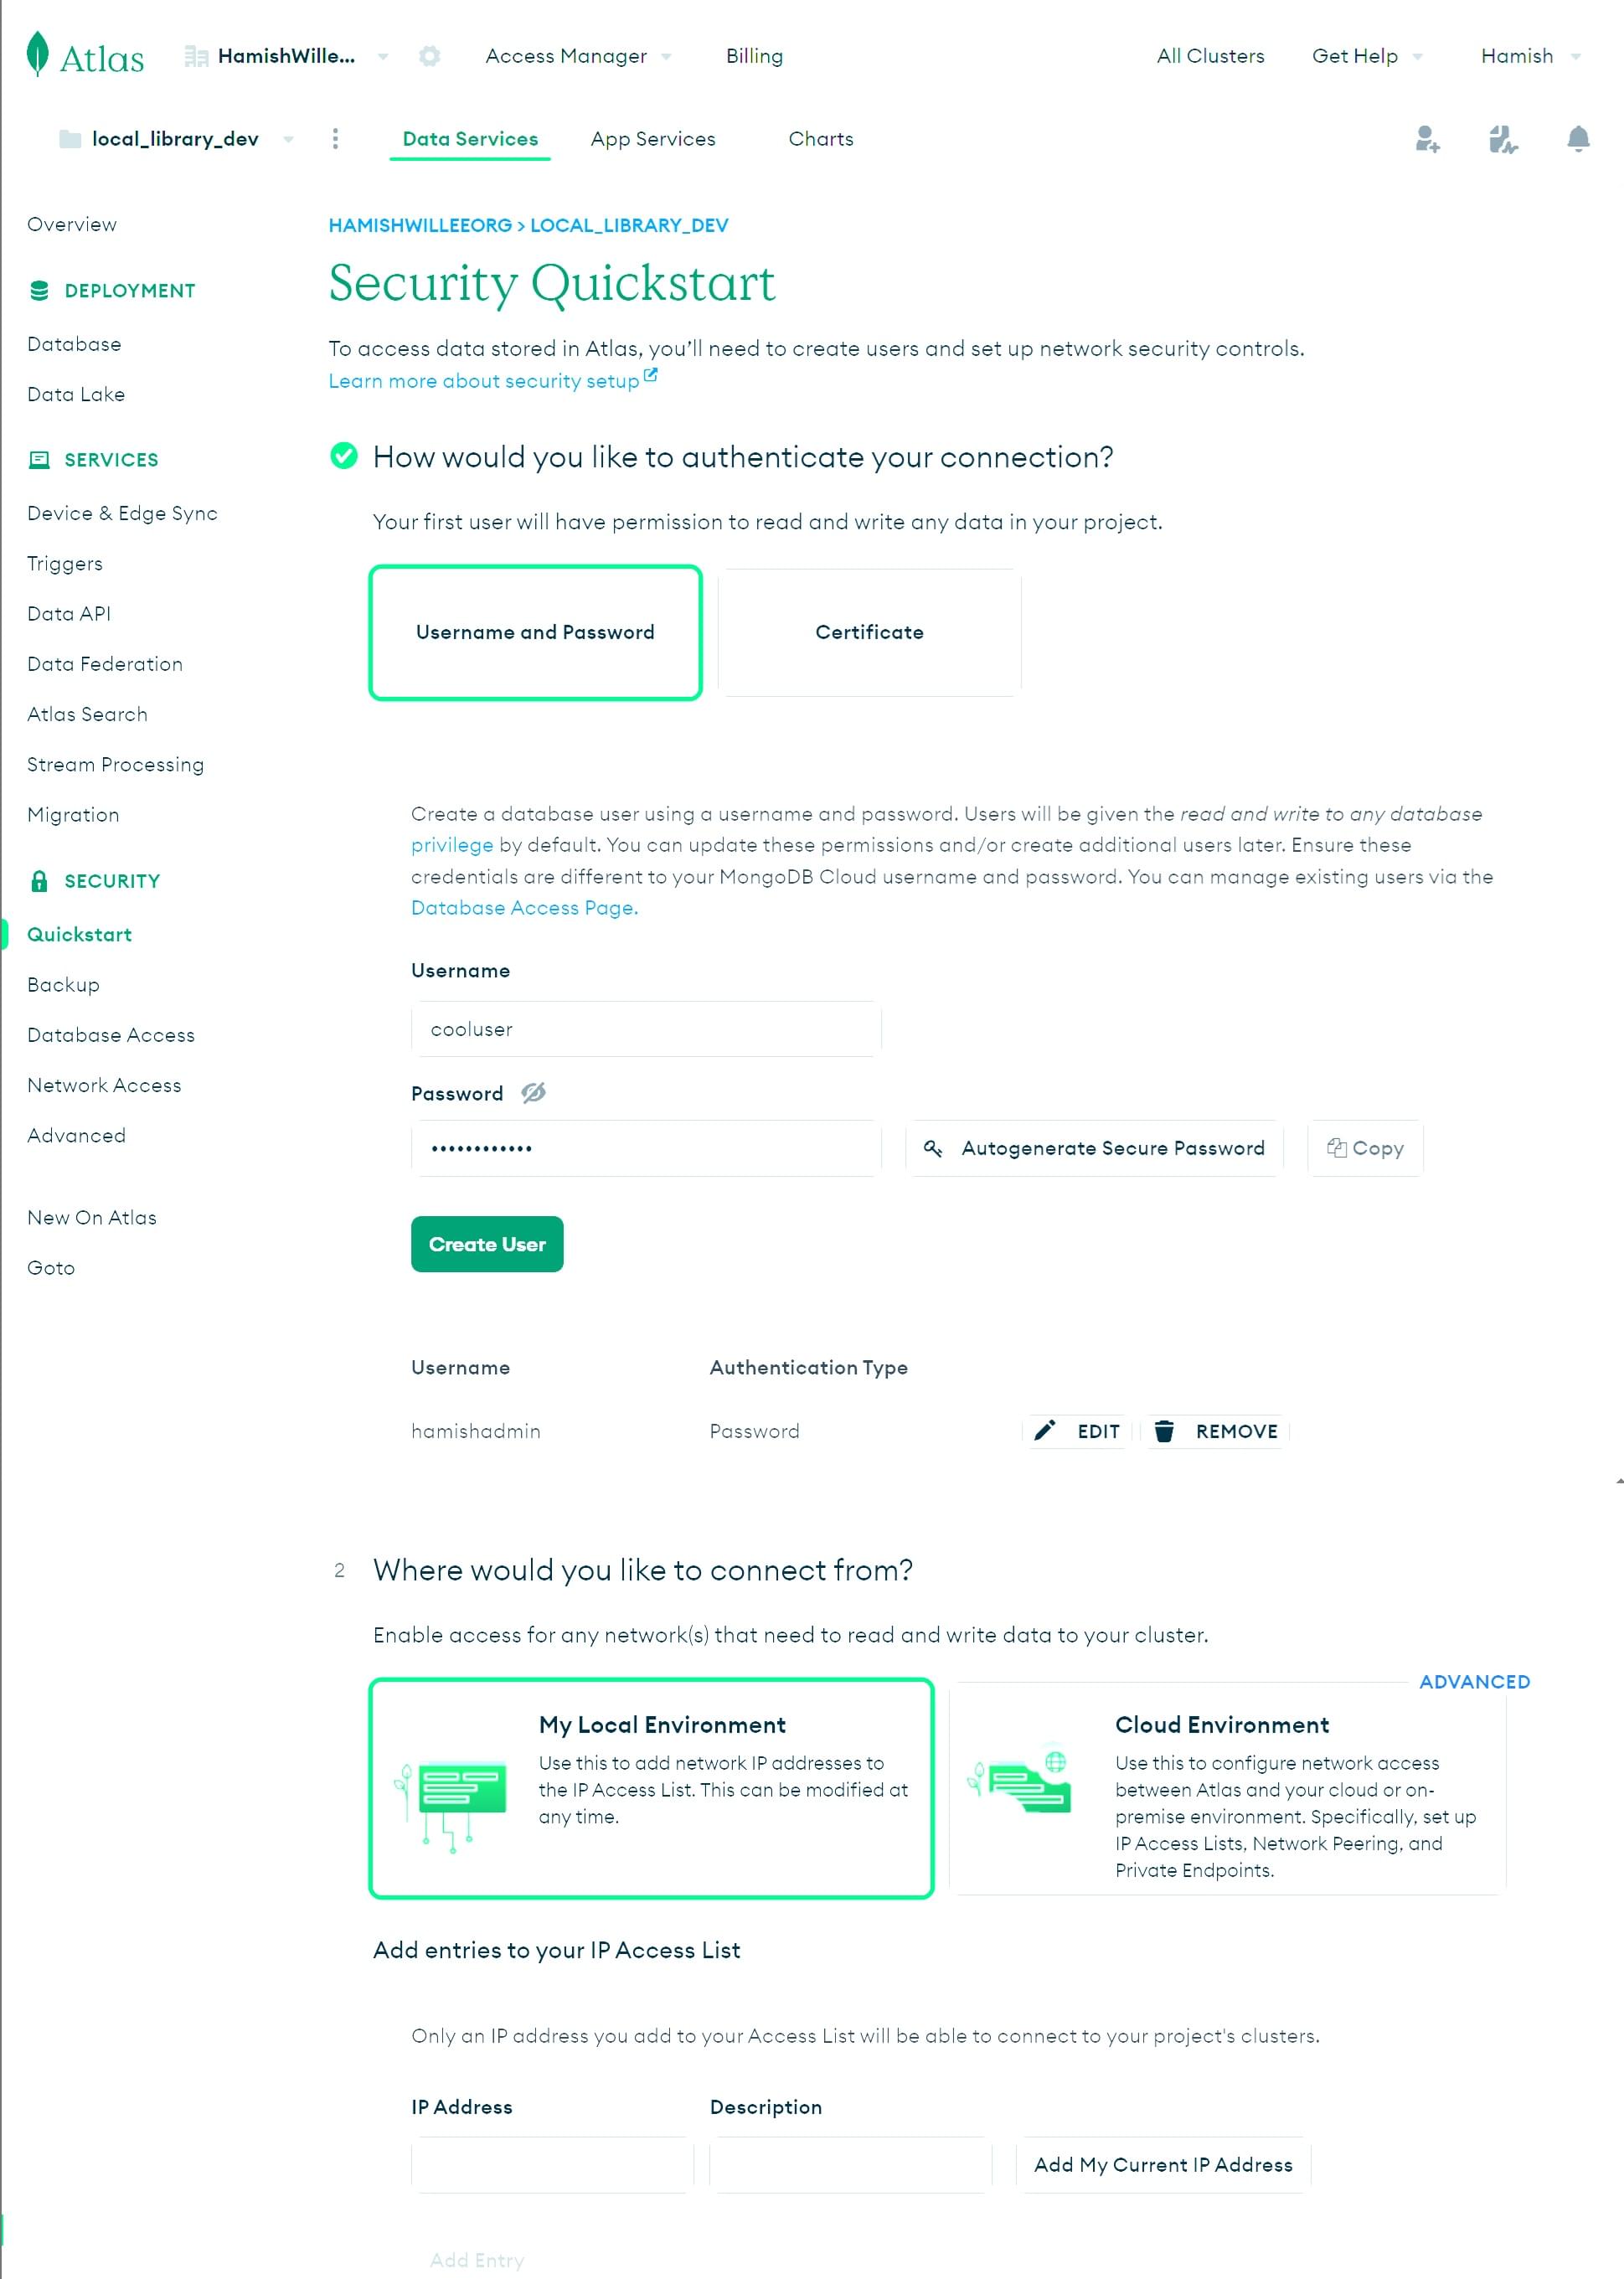
Daraufhin öffnet sich der Bereich Security Quickstart.
-
Geben Sie einen Benutzernamen und ein Passwort ein, mit denen Ihre Anwendung auf die Datenbank zugreifen soll. Oben haben wir die neuen Zugangsdaten „cooluser“ erstellt. Kopieren Sie die Zugangsdaten und bewahren Sie sie sicher auf, da wir sie später benötigen. Klicken Sie auf Create User.
Hinweis: Vermeiden Sie Sonderzeichen im Passwort Ihres MongoDB-Benutzers, da mongoose die Verbindungszeichenfolge möglicherweise nicht korrekt verarbeitet.
-
Wählen Sie Add by current IP address, um den Zugriff von Ihrem aktuellen Computer zu erlauben.
-
Geben Sie
0.0.0.0/0in das Feld „IP Address“ ein und klicken Sie anschließend auf Add Entry. Damit teilen Sie MongoDB mit, dass Zugriffe von überall aus erlaubt sein sollen.Hinweis: Es empfiehlt sich, die IP-Adressen einzuschränken, die eine Verbindung zu Ihrer Datenbank und anderen Ressourcen herstellen dürfen. Hier erlauben wir Verbindungen von überall, da wir nicht wissen, woher die Anfrage nach der Bereitstellung kommen wird.
-
Klicken Sie auf Finish and Close.
-
-
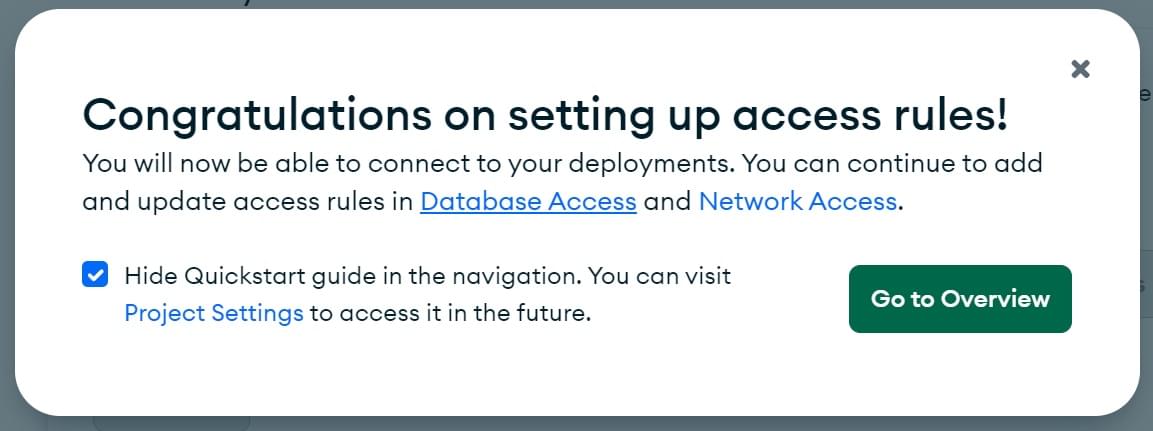
Daraufhin öffnet sich die folgende Ansicht. Klicken Sie auf Go to Overview.
-
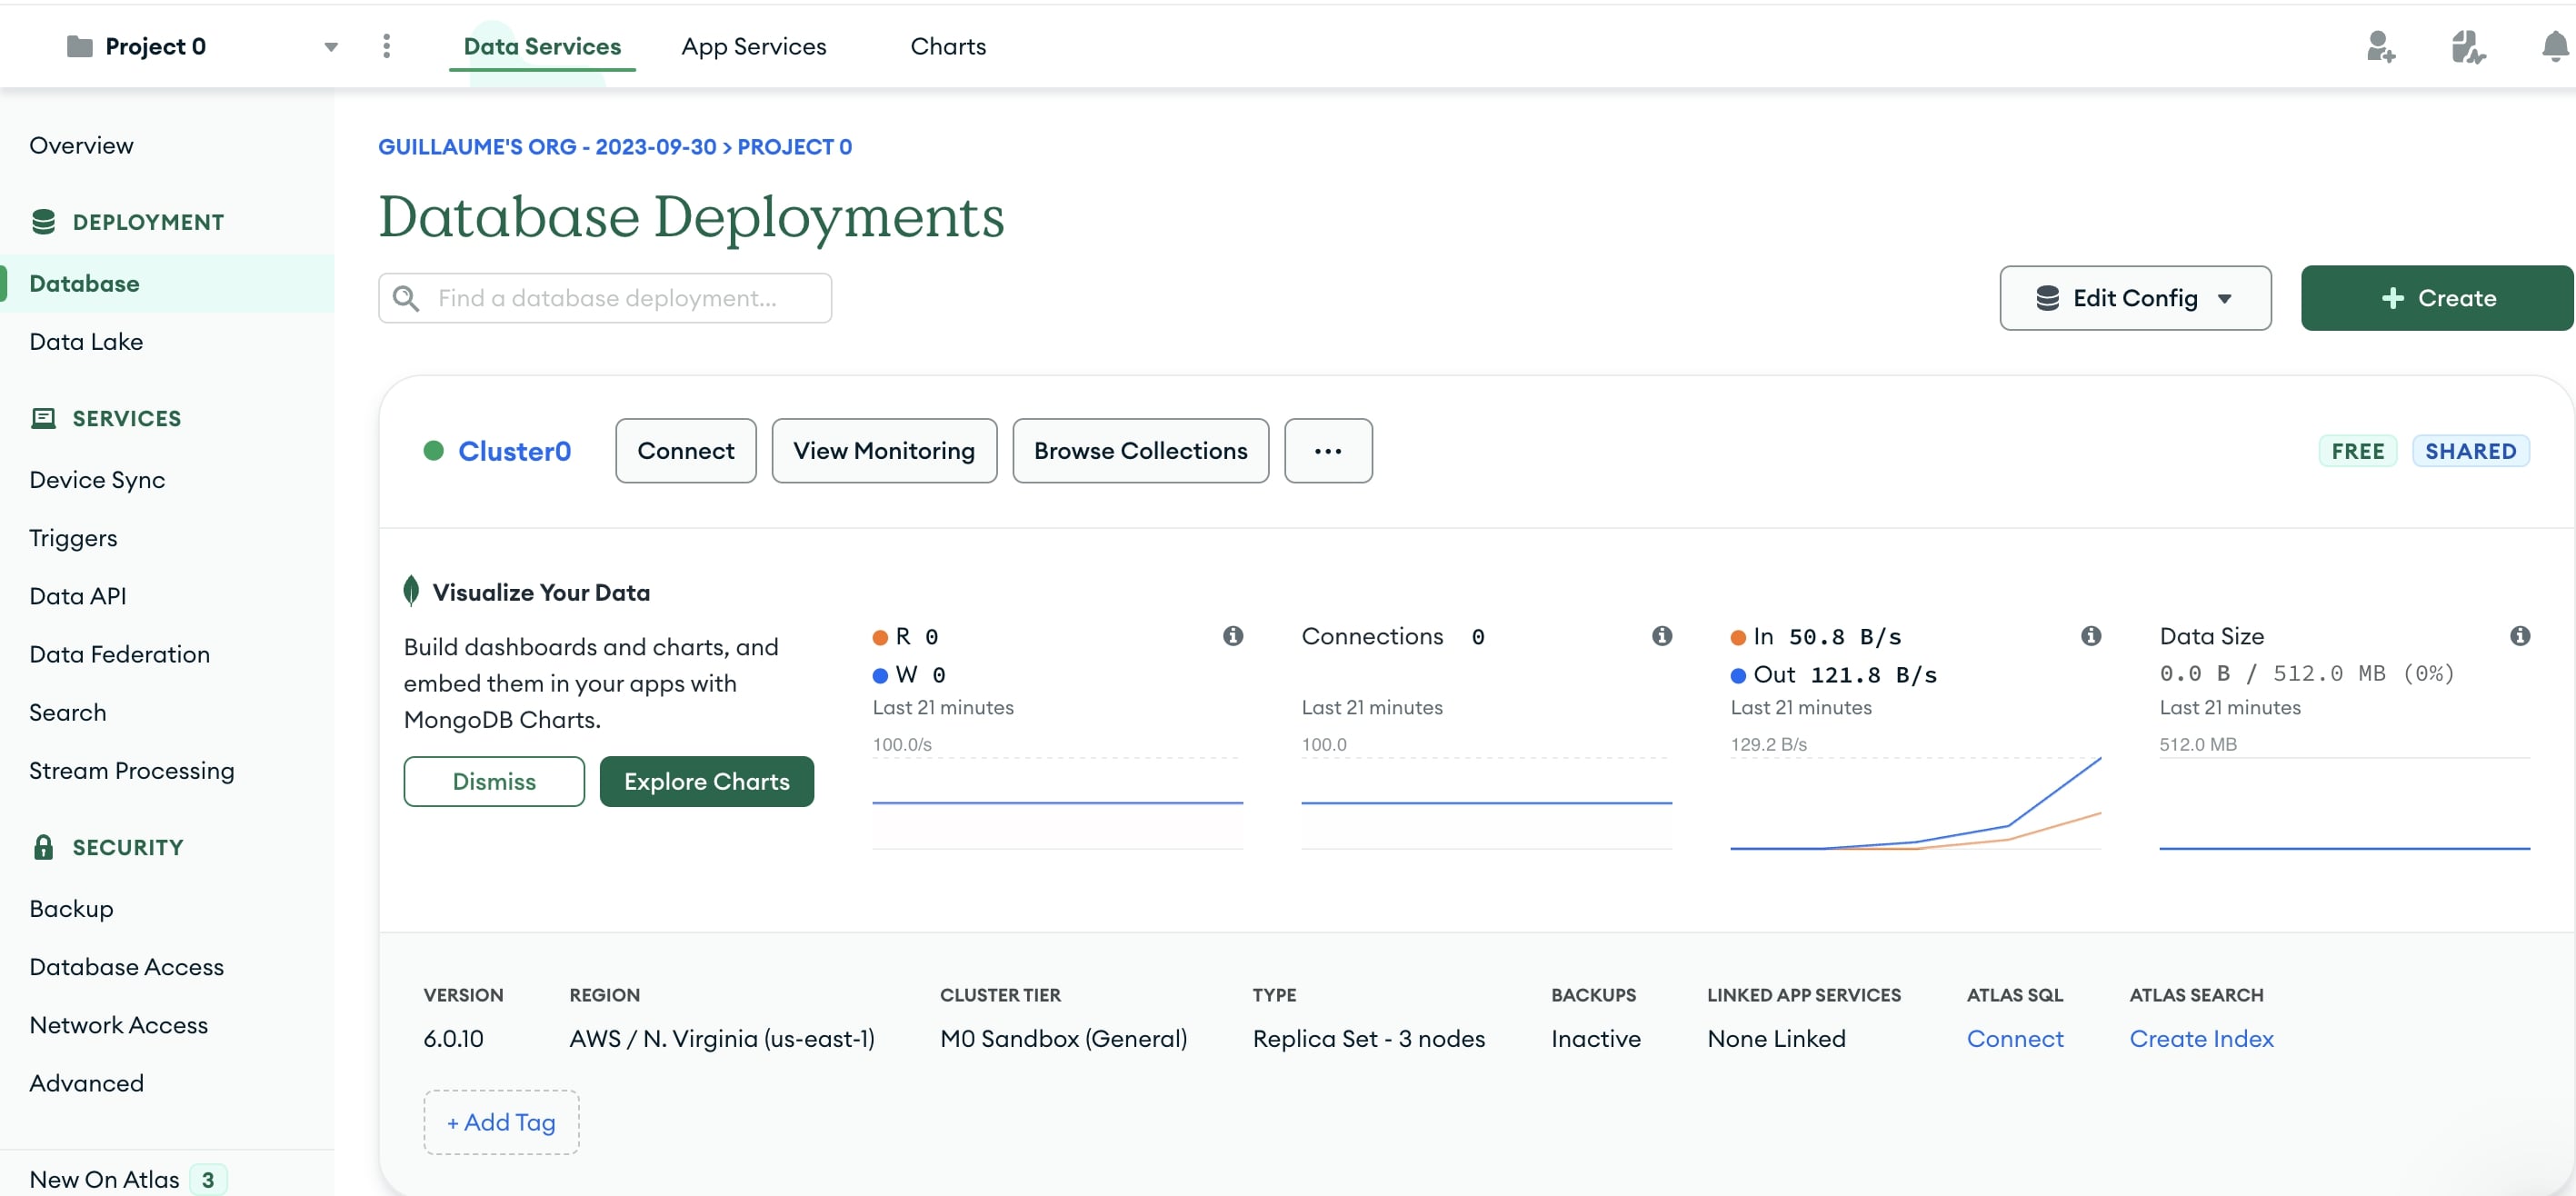
Sie gelangen zurück zur Ansicht Overview. Klicken Sie links im Menü Deployment auf den Bereich Database. Klicken Sie auf Browse Collections.
-
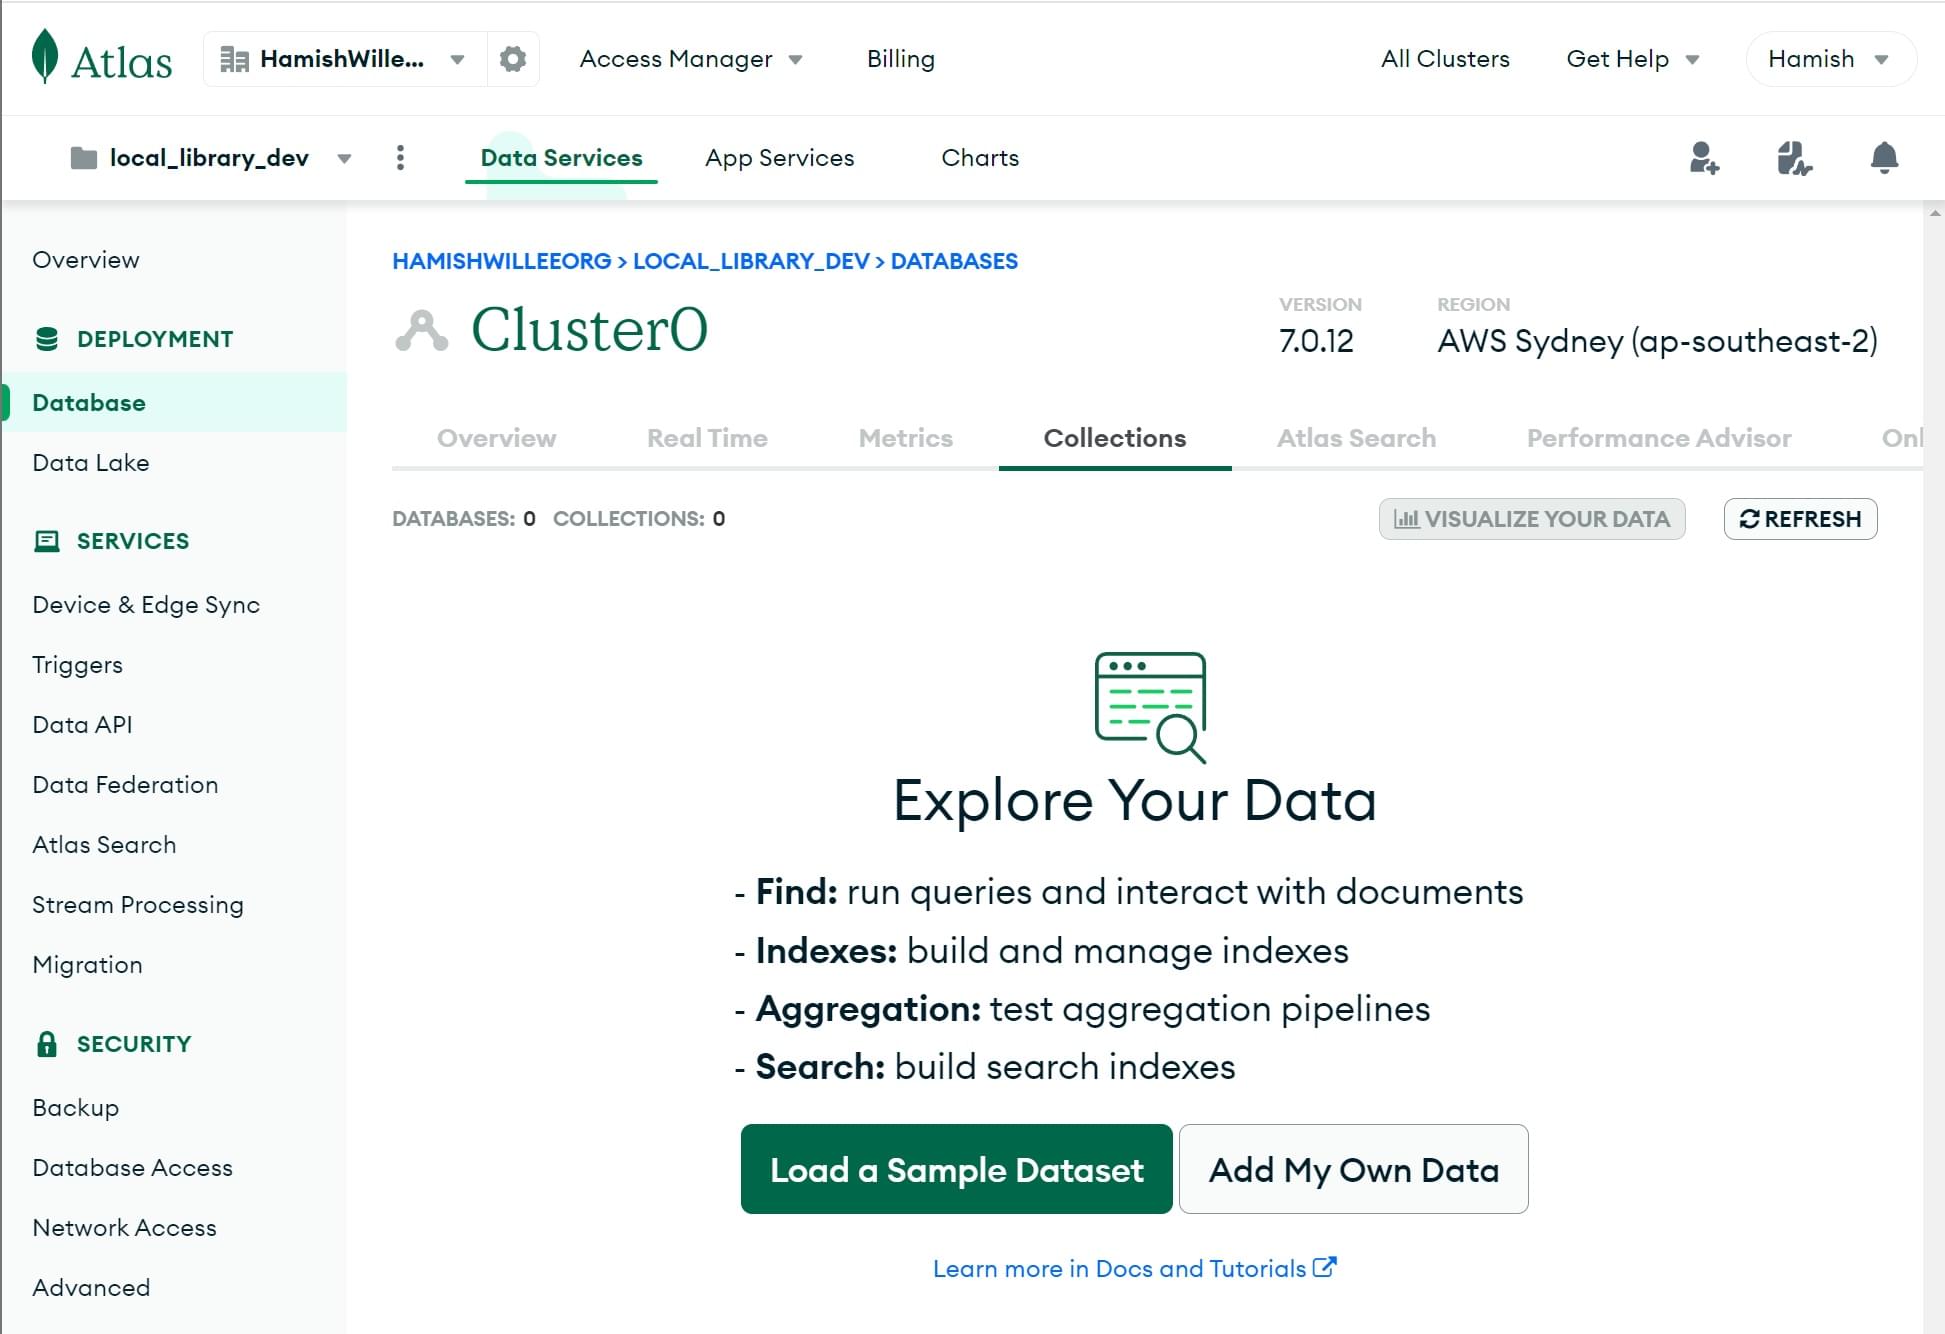
Daraufhin öffnet sich der Bereich Collections. Klicken Sie auf Add My Own Data.
-
Daraufhin öffnet sich die Ansicht Create Database.
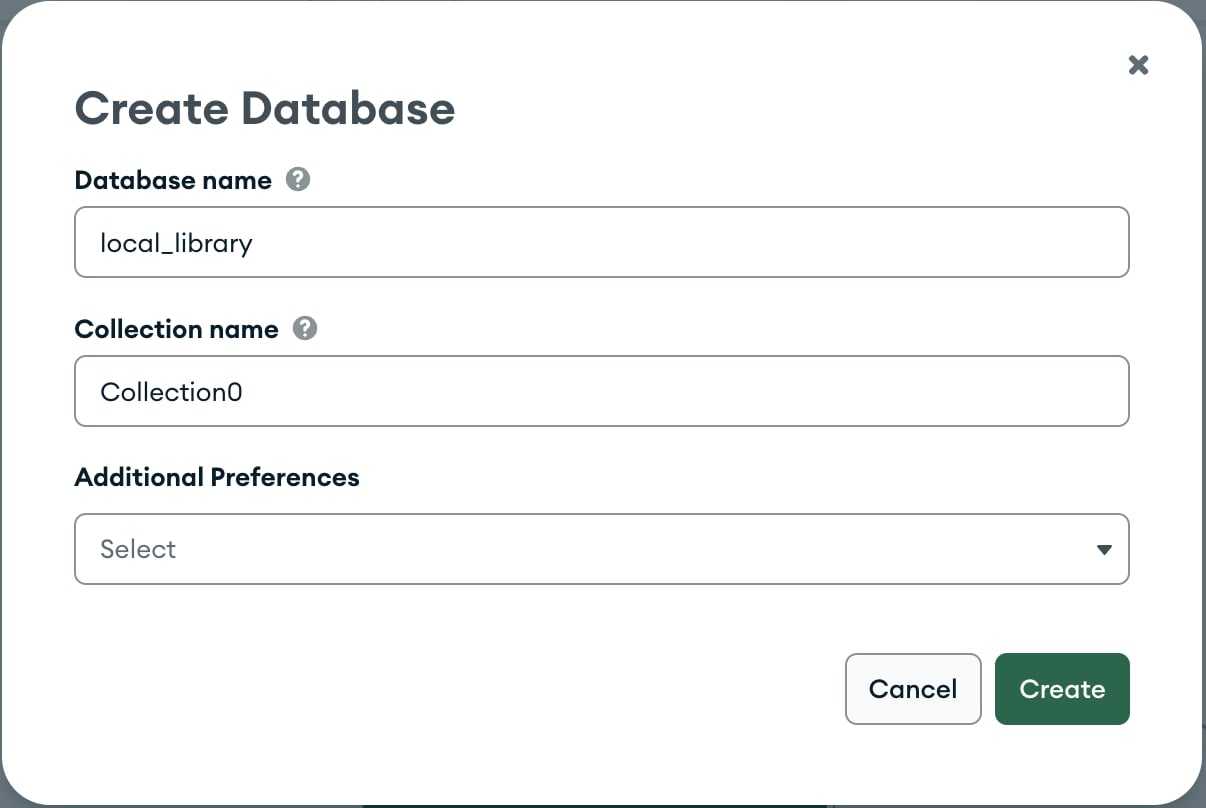
- Geben Sie
local_libraryals Namen der neuen Datenbank ein. - Geben Sie
Collection0als Namen der Collection ein. - Klicken Sie auf Create, um die Datenbank zu erstellen.
- Geben Sie
-
Sie gelangen zurück zur Ansicht Collections; Ihre Datenbank ist jetzt erstellt.
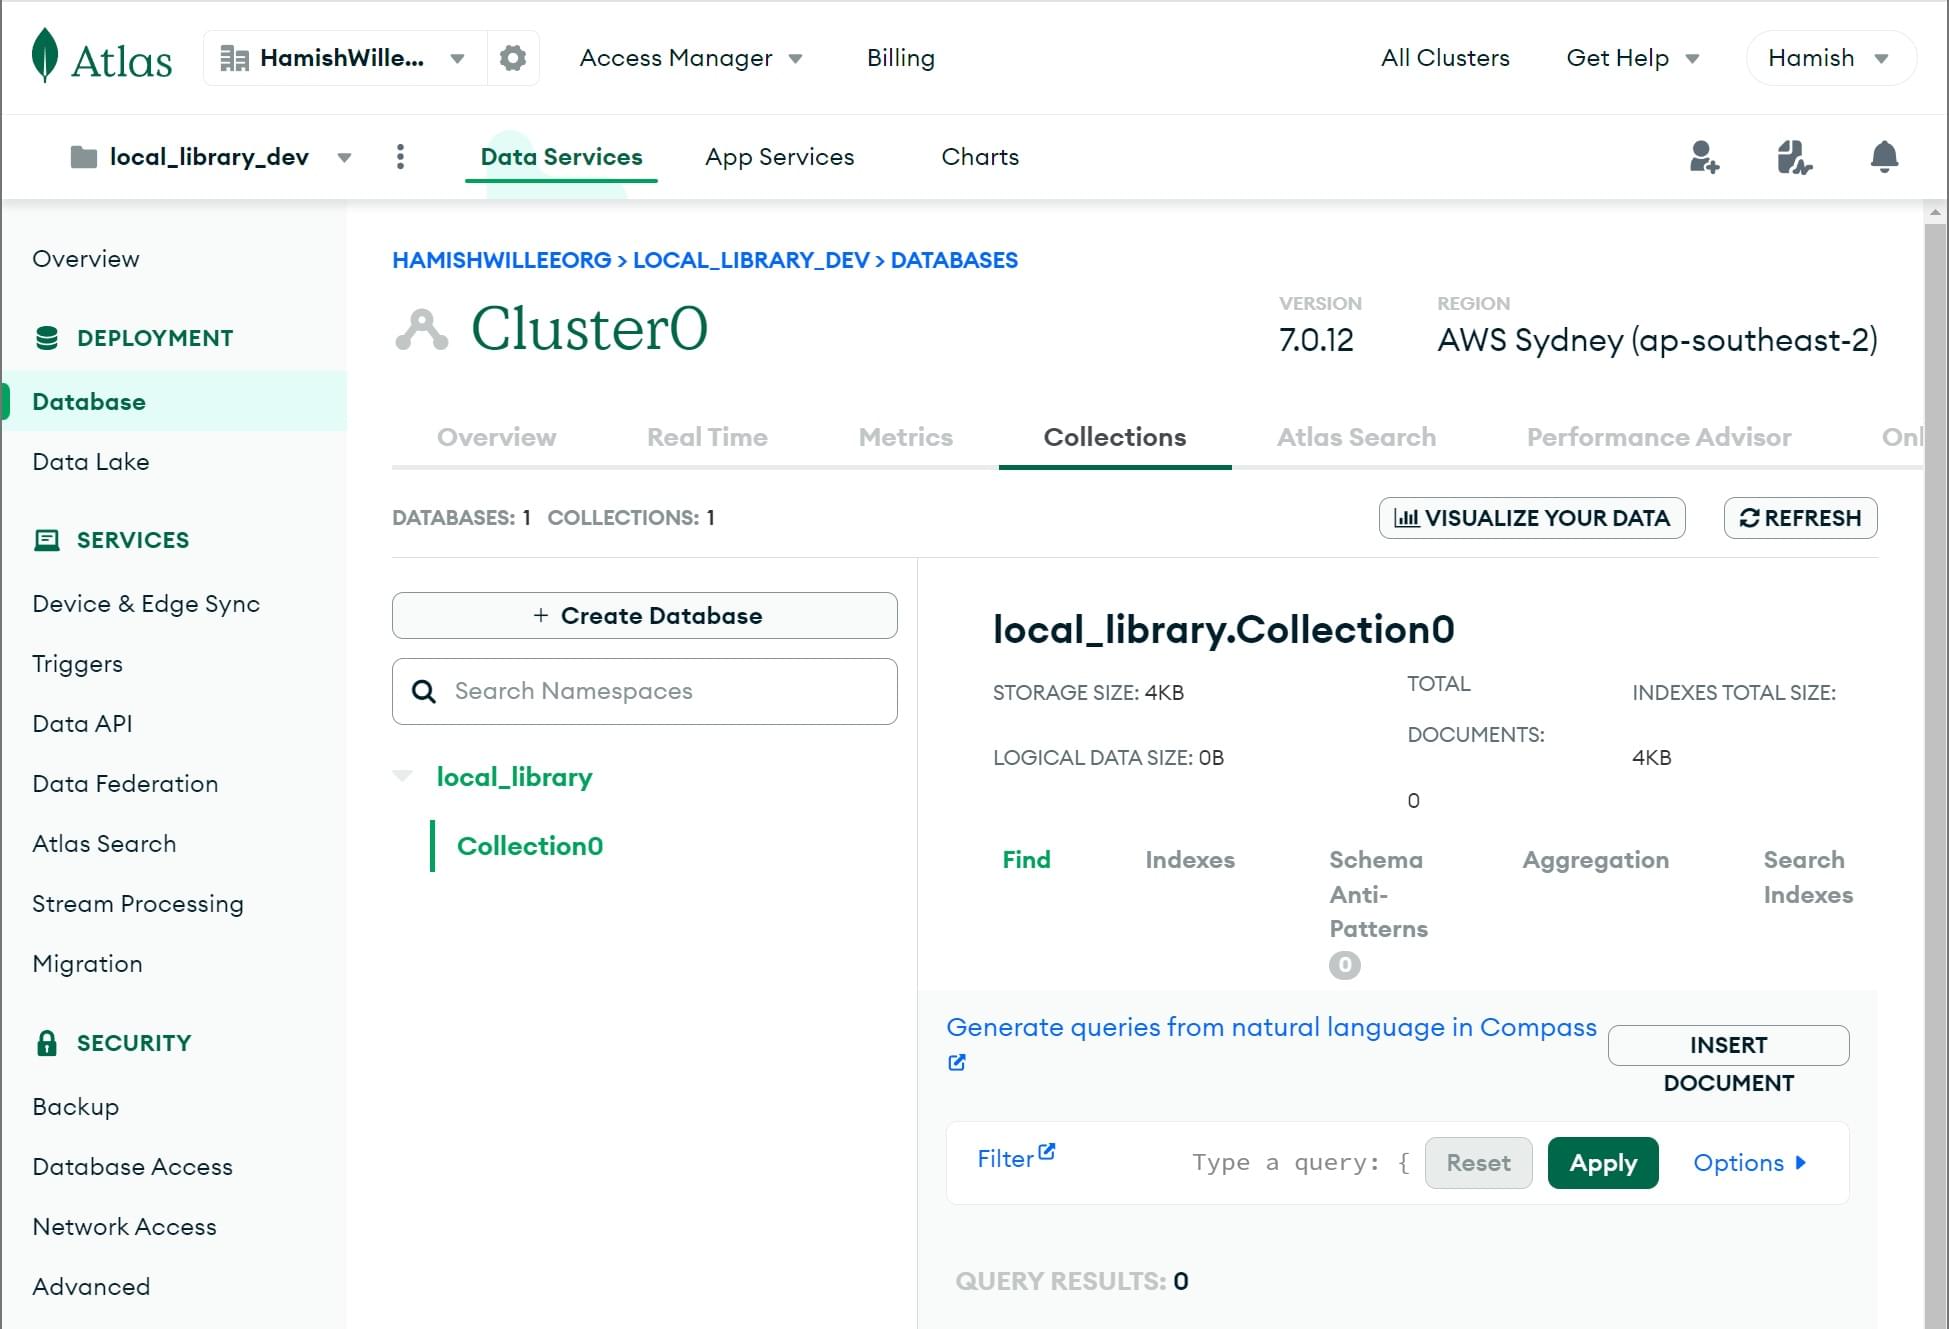
- Klicken Sie auf den Tab Overview, um zur Clusterübersicht zurückzukehren.
-
Klicken Sie in der Overview-Ansicht von Cluster0 auf Connect.
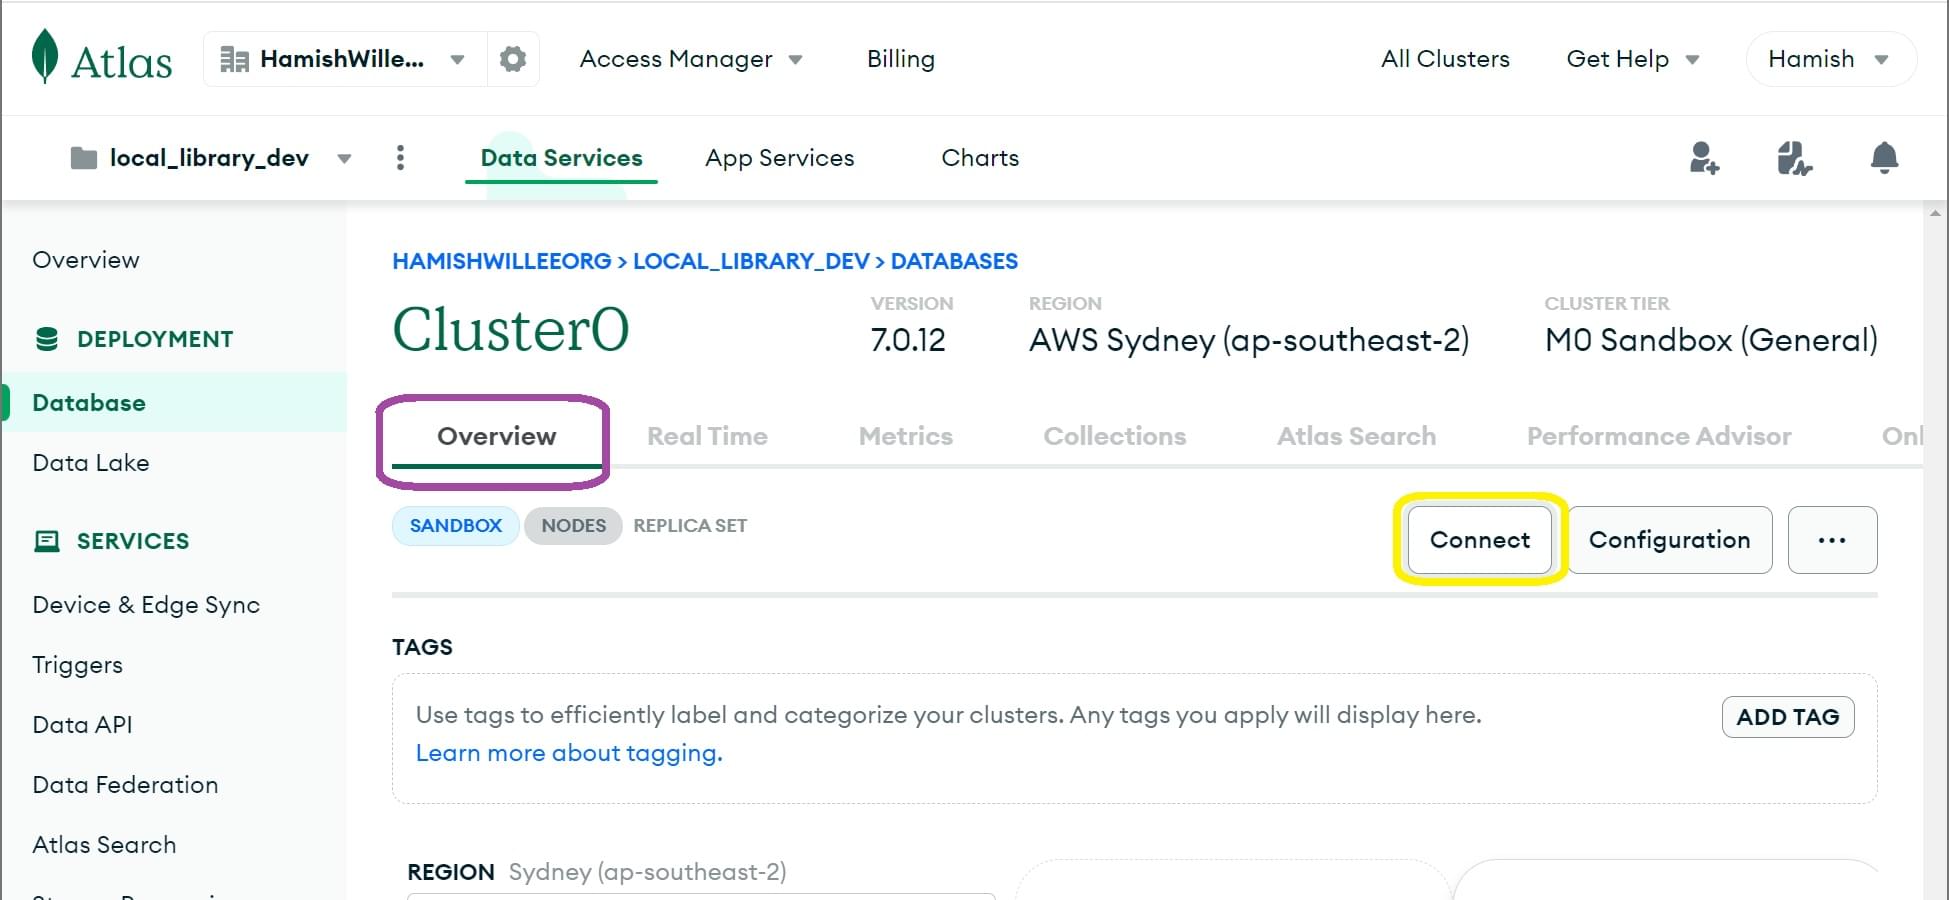
-
Daraufhin öffnet sich die Ansicht Connect to Cluster0.
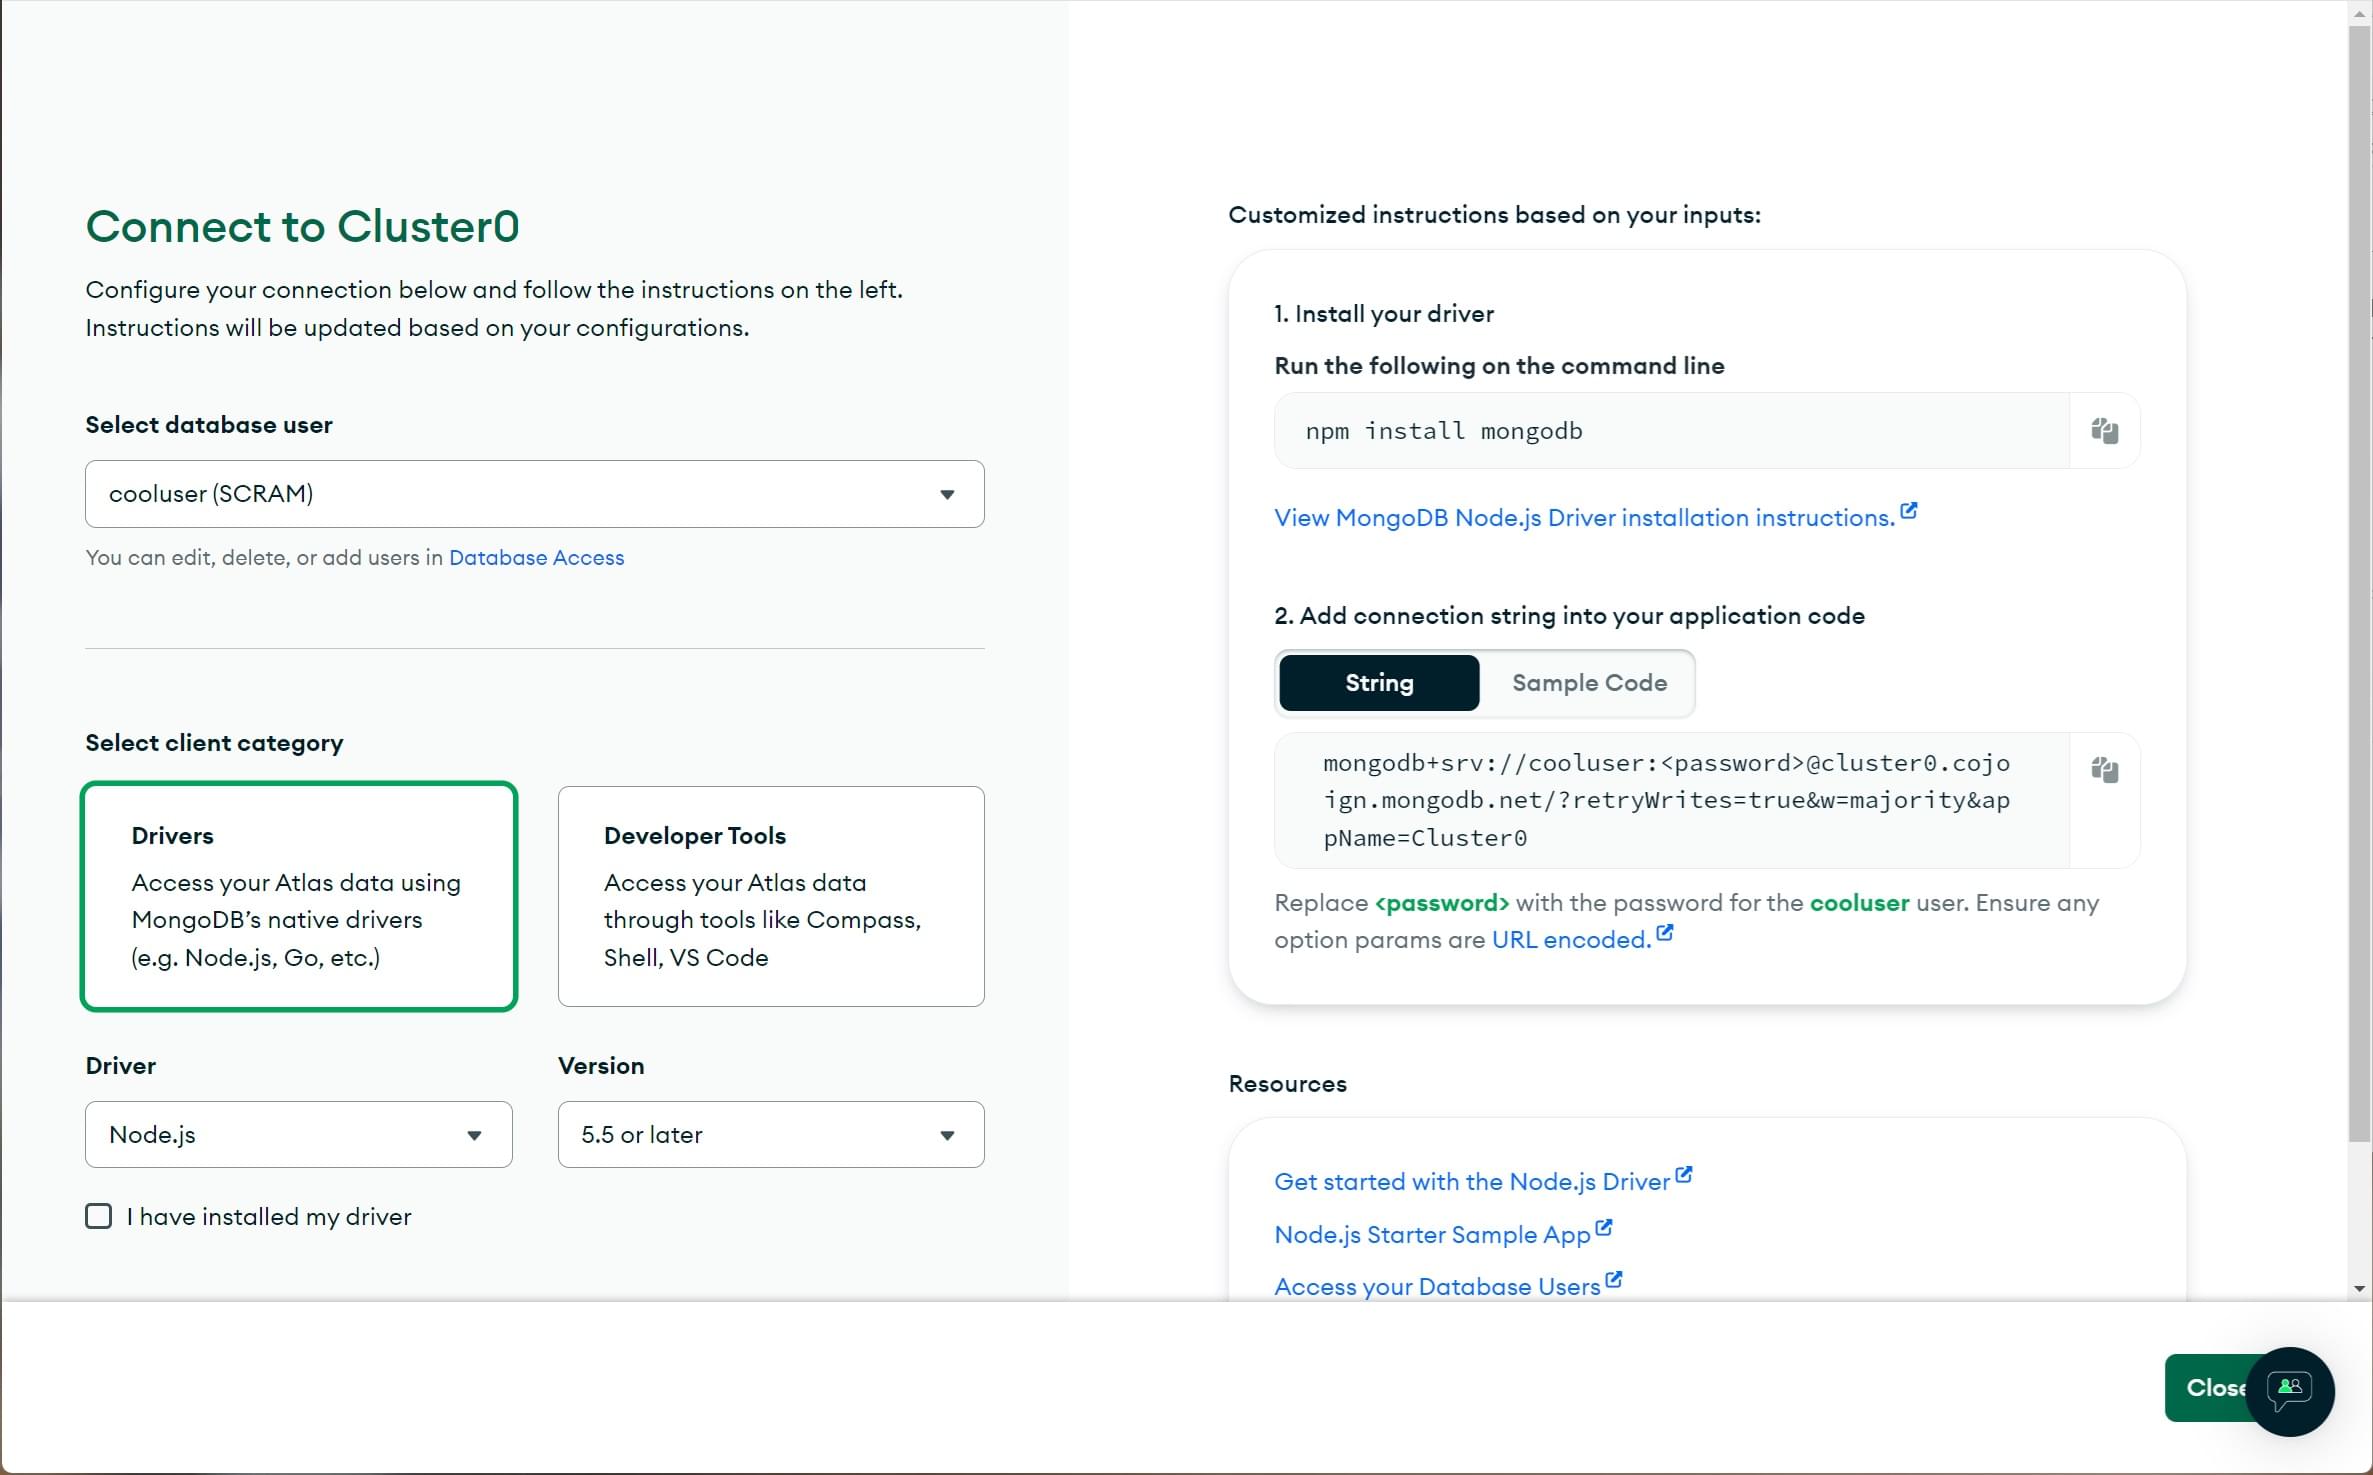
- Wählen Sie Ihren Datenbankbenutzer aus.
- Wählen Sie die Kategorie Drivers, dann unter Driver Node.js und die abgebildete Version.
- Installieren Sie den Treiber NICHT, auch wenn dies vorgeschlagen wird.
- Klicken Sie auf das Symbol Copy, um die Verbindungszeichenfolge zu kopieren.
- Fügen Sie sie in Ihren lokalen Texteditor ein.
- Ersetzen Sie den Platzhalter
<password>in der Verbindungszeichenfolge durch das Passwort Ihres Benutzers. - Fügen Sie den Datenbanknamen „local_library“ im Pfad vor den Optionen ein (
...mongodb.net/local_library?retryWrites...). - Speichern Sie die Datei mit dieser Zeichenfolge an einem sicheren Ort.
Sie haben nun die Datenbank erstellt und verfügen über eine URL mit Benutzername und Passwort, über die Sie darauf zugreifen können.
Sie sieht etwa so aus: mongodb+srv://your_user_name:your_password@cluster0.cojoign.mongodb.net/local_library?retryWrites=true&w=majority&appName=Cluster0
Mongoose installieren
Öffnen Sie eine Eingabeaufforderung und wechseln Sie in das Verzeichnis, in dem Sie die Grundstruktur der Local-Library-Website erstellt haben. Führen Sie den folgenden Befehl aus, um Mongoose und seine Abhängigkeiten zu installieren und es Ihrer Datei package.json hinzuzufügen – sofern Sie das nicht bereits beim Lesen der obigen Einführung in Mongoose getan haben.
npm install mongoose
Verbindung zu MongoDB herstellen
Öffnen Sie server.js im Stammverzeichnis Ihres Projekts und fügen Sie den Mongoose-Import oben in der Datei neben den anderen Paketimporten hinzu:
import mongoose from "mongoose";
Fügen Sie dann den folgenden Code nach app.set("port", port); und vor const server = createServer(app); ein. Ersetzen Sie die Datenbank-URL ("insert_your_database_url_here") durch die URL Ihrer Datenbank aus MongoDB Atlas.
const mongoDB = "insert_your_database_url_here";

mongoose.connection.on("error", (err) => {
  console.error("MongoDB connection error:", err);
});

mongoose.connection.on("disconnected", () => {
  console.warn("MongoDB disconnected");
});

await mongoose.connect(mongoDB);
Wie oben in der Einführung in Mongoose erläutert, wird damit die Standardverbindung hergestellt; Verbindungsfehler werden gemeldet. Da server.js ein ES-Modul ist, kann es await auf oberster Ebene verwenden. Node wartet auf die Verbindung, bevor der Code zum Erstellen und Starten des Servers fortgesetzt wird. Schlägt die anfängliche Verbindung fehl, kann das Modul nicht geladen werden und Node beendet sich, ohne den HTTP-Server zu starten.
Hinweis: Wenn die Datenbankverbindung in server.js verbleibt, kann app.js die Anwendung konfigurieren und exportieren, ohne eine Verbindung zur Datenbank herzustellen oder einen Server zu starten.
Warnung: Wir schreiben die Datenbankzugangsdaten fest in den Quellcode – das ist eine ausgesprochen schlechte Vorgehensweise. Wir tun es hier, um den grundlegenden Verbindungscode zu zeigen. Außerdem besteht während der Entwicklung kein erhebliches Risiko, dass durch eine Weitergabe dieser Angaben vertrauliche Informationen offengelegt oder beschädigt werden. Wenn Sie Ihren Code auf GitHub committen und pushen, hören Sie sofort auf, Commits zu erstellen, bis wir dieses Tutorial abgeschlossen haben. Wenn Sie den Code committen, bleiben Ihre Datenbankzugangsdaten dauerhaft im Git-Verlauf und sind für alle Personen zugänglich, die Zugriff auf Ihr GitHub-Repository haben. Bei der Bereitstellung für die Produktion zeigen wir Ihnen, wie Sie das sicherer lösen.
Falls Ihre Datenbankzugangsdaten versehentlich in veröffentlichten Quellcode gelangen, ändern Sie umgehend Ihr Datenbankpasswort.
Das LocalLibrary-Schema definieren
Wie oben besprochen, definieren wir für jedes Modell ein eigenes Modul. Erstellen Sie zunächst im Projektstamm einen Ordner für unsere Modelle (models/) und darin für jedes Modell eine eigene Datei:
express-locallibrary-tutorial
├── models
│   ├── author.js
│   ├── book.js
│   ├── bookinstance.js
│   └── genre.js
...
Wenn Sie Bash oder eine ähnliche Shell verwenden, können Sie alle Dateien mit diesem Befehl erstellen:
mkdir models && touch models/{author,book,bookinstance,genre}.js
Author-Modell
Kopieren Sie den unten gezeigten Schemacode für Author in die Datei ./models/author.js.
Das Schema definiert für eine Autorin oder einen Autor String-SchemaTypes für Vor- und Nachnamen – beide erforderlich und auf höchstens 100 Zeichen begrenzt – sowie Date-Felder für Geburts- und Sterbedatum.
import mongoose from "mongoose";

const Schema = mongoose.Schema;

const AuthorSchema = new Schema({
  first_name: { type: String, required: true, maxLength: 100 },
  family_name: { type: String, required: true, maxLength: 100 },
  date_of_birth: { type: Date },
  date_of_death: { type: Date },
});

// Virtual for author's full name
AuthorSchema.virtual("name").get(function () {
  // To avoid errors in cases where an author does not have either a family name or first name
  // We want to make sure we handle the exception by returning an empty string for that case
  let fullname = "";
  if (this.first_name && this.family_name) {
    fullname = `${this.family_name}, ${this.first_name}`;
  }

  return fullname;
});

// Virtual for author's URL
AuthorSchema.virtual("url").get(function () {
  // We don't use an arrow function as we'll need the this object
  return `/catalog/author/${this._id}`;
});

// Export model
export default mongoose.model("Author", AuthorSchema);
Außerdem haben wir für das AuthorSchema eine virtuelle Eigenschaft namens „url“ deklariert. Sie gibt die absolute URL zurück, über die eine bestimmte Instanz des Modells abgerufen werden kann. Wir verwenden diese Eigenschaft in unseren Vorlagen, wenn wir einen Link zu einer bestimmten Autorin oder einem bestimmten Autor benötigen.
Hinweis: URLs als virtuelle Eigenschaften im Schema zu deklarieren, ist sinnvoll: Die URL eines Eintrags muss dann nur an einer Stelle geändert werden. Derzeit würde ein Link mit dieser URL noch nicht funktionieren, weil wir noch keinen Code für Routen eingerichtet haben, die einzelne Modellinstanzen verarbeiten. Das erledigen wir in einem späteren Artikel!
Am Ende des Moduls exportieren wir das Modell.
Book-Modell
Kopieren Sie den unten gezeigten Schemacode für Book in die Datei ./models/book.js.
Vieles ähnelt dem Author-Modell: Wir deklarieren ein Schema mit mehreren Zeichenfolgenfeldern und einer virtuellen Eigenschaft für die URL bestimmter Buchdatensätze und exportieren das Modell.
import mongoose from "mongoose";

const Schema = mongoose.Schema;

const BookSchema = new Schema({
  title: { type: String, required: true },
  author: { type: Schema.Types.ObjectId, ref: "Author", required: true },
  summary: { type: String, required: true },
  isbn: { type: String, required: true },
  genre: [{ type: Schema.Types.ObjectId, ref: "Genre" }],
});

// Virtual for book's URL
BookSchema.virtual("url").get(function () {
  // We don't use an arrow function as we'll need the this object
  return `/catalog/book/${this._id}`;
});

// Export model
export default mongoose.model("Book", BookSchema);
Der wichtigste Unterschied besteht darin, dass wir zwei Referenzen auf andere Modelle erstellt haben:
- author ist eine erforderliche Referenz auf ein einzelnes
Author-Modellobjekt. - genre ist eine Referenz auf ein Array von
Genre-Modellobjekten. Dieses Modell haben wir noch nicht deklariert!
BookInstance-Modell
Kopieren Sie schließlich den unten gezeigten Schemacode für BookInstance in die Datei ./models/bookinstance.js.
BookInstance repräsentiert ein bestimmtes Exemplar eines Buchs, das ausgeliehen werden kann. Das Modell enthält Angaben dazu, ob das Exemplar verfügbar ist, wann es voraussichtlich zurückgegeben wird, sowie Details zur „Ausgabe“ bzw. Version.
import mongoose from "mongoose";

const Schema = mongoose.Schema;

const BookInstanceSchema = new Schema({
  book: { type: Schema.Types.ObjectId, ref: "Book", required: true }, // reference to the associated book
  imprint: { type: String, required: true },
  status: {
    type: String,
    required: true,
    enum: ["Available", "Maintenance", "Loaned", "Reserved"],
    default: "Maintenance",
  },
  due_back: { type: Date, default: Date.now },
});

// Virtual for bookinstance's URL
BookInstanceSchema.virtual("url").get(function () {
  // We don't use an arrow function as we'll need the this object
  return `/catalog/bookinstance/${this._id}`;
});

// Export model
export default mongoose.model("BookInstance", BookInstanceSchema);
Neu sind hier die Feldoptionen:
enum: Damit legen wir die zulässigen Werte einer Zeichenfolge fest. Hier verwenden wir die Option, um den Verfügbarkeitsstatus unserer Bücher vorzugeben. So verhindern wir Schreibfehler und beliebige Statuswerte.default: Mit dieser Option setzen wir den Standardstatus neu erstellter Buchexemplare auf „Maintenance“ und das Standarddatum fürdue_backaufnow. Beachten Sie, wie beim Setzen des Datums die Date-Funktion aufgerufen werden kann!
Alles Weitere sollte Ihnen aus den vorherigen Schemas bekannt sein.
Genre-Modell – Übung
Öffnen Sie die Datei ./models/genre.js und erstellen Sie ein Schema zum Speichern von Genres – also Buchkategorien wie Belletristik oder Sachbuch, Liebesroman oder Militärgeschichte.
Die Definition ähnelt stark den anderen Modellen:
- Das Modell soll einen
String-SchemaType namensnameenthalten, der das Genre beschreibt. - Dieser Name soll erforderlich sein und zwischen 3 und 100 Zeichen umfassen.
- Deklarieren Sie eine virtuelle Eigenschaft namens
urlfür die URL des Genres. - Exportieren Sie das Modell.
Testen – einige Einträge erstellen
Damit sind alle Modelle für die Website eingerichtet!
Um die Modelle zu testen und einige Beispielbücher sowie weitere Einträge für die nächsten Artikel zu erstellen, führen wir nun ein eigenständiges Skript aus, das Einträge jedes Typs erzeugt:
-
Laden Sie die Datei populatedb.js herunter oder erstellen Sie sie auf andere Weise im Verzeichnis express-locallibrary-tutorial (auf derselben Ebene wie
package.json).Hinweis: Der Code in
populatedb.jskann beim Lernen von JavaScript hilfreich sein. Für dieses Tutorial müssen Sie ihn aber nicht verstehen. -
Führen Sie das Skript in Ihrer Eingabeaufforderung mit node aus und übergeben Sie die URL Ihrer MongoDB-Datenbank. Verwenden Sie dieselbe URL, mit der Sie zuvor in
server.jsden Platzhalter insert_your_database_url_here ersetzt haben:bashnode populatedb.js "<your MongoDB URL>"Denken Sie daran, die URL in doppelte Anführungszeichen zu setzen.
-
Das Skript sollte vollständig durchlaufen und die erstellten Einträge währenddessen im Terminal anzeigen.
Hinweis: Öffnen Sie Ihre Datenbank in MongoDB Atlas auf dem Tab Collections. Sie sollten nun die einzelnen Collections für Books, Authors, Genres und BookInstances öffnen und die jeweiligen Dokumente ansehen können.
Zusammenfassung
In diesem Artikel haben wir Grundlagen zu Datenbanken und ORMs unter Node/Express kennengelernt und ausführlich betrachtet, wie Schemas und Modelle in Mongoose definiert werden. Mit diesem Wissen haben wir die Modelle Book, BookInstance, Author und Genre für die LocalLibrary-Website entworfen und implementiert.
Abschließend haben wir unsere Modelle getestet, indem wir mit einem eigenständigen Skript mehrere Instanzen erstellt haben. Im nächsten Artikel sehen wir uns an, wie Sie Seiten zur Anzeige dieser Objekte erstellen.
Siehe auch
- Datenbankintegration (Express-Dokumentation)
- Mongoose-Website (Mongoose-Dokumentation)
- Mongoose-Leitfaden (Mongoose-Dokumentation)
- Validierung (Mongoose-Dokumentation)
- Schematypen (Mongoose-Dokumentation)
- Modelle (Mongoose-Dokumentation)
- Abfragen (Mongoose-Dokumentation)
- Population (Mongoose-Dokumentation)